K8s 1.37 新特性:原生 Gang Scheduling 与 HPA Scale to Zero
 意琦行 收录于 Kubernetes
Kubernetes 1.37 已于 2026 年 8 月 26 日发布,今天分享其中两项值得关注的新特性。 原生 Gang Scheduling 和 HPA Scale to Zero 都进入 Beta 了。前者让调度器能够按一组 Pod 来判断资源是否够用,后者让空闲的 Pod 自动缩到零,新任务来了再启动。
这篇主要分享这两个特性,顺便搭一个集群实际跑一下,看看用起来是什么效果。
1.K8s 1.37 主要新特性
Kubernetes 1.37 更新主要在资源管理和调度方面:
- 原生 Gang Scheduling、HPA Scale to Zero 进入 Beta
- DRA 的扩展资源支持和设备污点等能力正式 GA
- Memory QoS 也进入 Beta
- 同时 Metrics API 也正式稳定
- PVC 新增闲置状态追踪,Pod 证书与信任包进入 GA。
更多新特性可以参考 Kubernetes v1.37 官方发布公告。
这篇主要挑 Gang Scheduling 和 HPA Scale to Zero 展开,看看实际怎么用。
2.重点特性介绍
2.1 Gang Scheduling
Gang Scheduling 并不是什么新概念,在 k8s 生态中,早在 2018 年左右就受到关注了,大致发展分为以下几个阶段:
- 2018-2020:早期探索,主要解决 TensorFlow、MPI、Spark 等分布式任务的调度问题,代表项目 kube-batch 和 Volcano。
- 2021-2024:逐步普及,随着越来越多的大数据、AI 训练等分布式任务切换到 K8s 底座,Gang Scheduling 逐渐成为了重要调度能力,Volcano 等项目持续发展。
- 2025-2026:走向原生,Kubernetes 将 Gang Scheduling 纳入原生调度体系,先后在 v1.35、v1.36、v1.37 中实现和完善。
1.37 除了将核心 API 提升至 Beta,还让 PodGroup 直接作为调度队列中的单元,允许动态修改 minCount,并将 Workload-Aware Preemption 合并到 GenericWorkload 开关中。
核心对象
原生 Gang Scheduling 引入了两个核心对象:Workload 和 PodGroup。
Workload 保存调度策略模板。 比如一个任务需要两个 Worker 一起调度,可以这样定义:
| |
这里定义了一个名为 workers 的模板,要求至少两个成员满足调度条件。Workload 本身不会创建 Pod,也不会因为创建了模板就自动生成 PodGroup;这些工作需要相应的控制器完成。
PodGroup 表示实际参与调度的一组 Pod,保存这组的调度要求和状态。 根据上面的模板创建的 PodGroup 可以写成:
| |
workloadRef 标明使用了哪个模板,实际调度规则则保存在 PodGroup 自己的 schedulingPolicy 中。Pod 通过下面的字段加入这个组:
| |
这样,同一个 Workload 模板可以用于创建多个 PodGroup,每个组分别记录自己的调度状态。Pod 仍由 Job 等控制器或用户创建,PodGroup 负责表达组调度要求。
PodGroup 也可以独立使用,不需要先创建 Workload。 后面的 Demo 就采用这种方式,直接创建 PodGroup 和 Pod,观察资源不足时的调度行为。
原生支持之后,Volcano 还有必要吗
K8s 原生支持 Gang Scheduling 之后还有必要使用 Volcano 吗?
提到 Gang Scheduling 大家就会想到 Volcano,但是 Volcano 的功能却不止于此。 Volcano 还负责批处理作业管理,以及多个团队、多个作业之间的资源分配。这些需求并没有因为原生支持 Gang 而消失。
- 如果只需要简单的 Gang Scheduling,那可以优先考虑 K8s 原生能力,没必要专门引入 Volcano 之类的项目
- 需要多租户 GPU 队列、资源借用与回收、公平调度,那么 Volcano 仍然有明显价值。
关键在于:K8s 原生 Gang Scheduling 解决的是“一组 Pod 如何一起调度”,Volcano 解决的则是“多组作业如何公平、高效地共享整个集群的资源”。
2.2 HPA Scale to Zero
早在 Serverless 兴起时期,K8s 就在探索工作负载的零副本弹性伸缩。同样可以大致分为三个阶段:
- 2018-2020:随着 Serverless 和事件驱动架构的发展,Knative、KEDA 等项目相继出现,实现了工作负载从 0 到 N 的弹性伸缩。K8s 也早在 v1.16 就引入了 HPA Scale to Zero 的 Alpha 实现。
- 2021-2025:生态发展。 KEDA、Knative 等项目持续完善零副本伸缩能力,逐渐应用于事件驱动服务、消息队列消费者和 Serverless 工作负载,但 Kubernetes 原生 HPA 的相关能力仍长期停留在 Alpha 阶段。
- 2026:原生能力完善,K8s v1.36 改进了 HPA Scale to Zero 的状态管理与扩缩容逻辑,v1.37 则正式将其提升至 Beta 并默认启用,使基于 Object、External Metrics 的工作负载可以通过原生 HPA 实现从 0 到 N 的自动伸缩。
零副本靠什么唤醒?
Scale to Zero 并不难,最大的问题其实是零副本靠什么唤醒。
传统 HPA 常用 CPU、内存指标扩缩容,但副本缩到零之后,Pod 指标也没了,拿什么发现新任务?
所以零副本伸缩需要独立存在的 Object 或 External 指标。一般是通过额外的队列长度来解决这个问题,零副本之后新任务仍可以入队。HPA 持续读取这个独立存在的指标,就能知道什么时候该启动消费者。
minReplicas: 0至少需要一个 Object 或 External 指标,只有 CPU、内存指标的配置会被 API Server 拒绝。
1.37 中 HPAScaleToZero 在 kube-apiserver 和 kube-controller-manager 上默认开启,这里直接配置 HPA。后面会用 ScaledToZero Condition 区分自动归零和手动暂停。
与 KEDA、Knative 的分工
KEDA、Knative 早就能缩到零,原生 HPA 补上这项能力后,它们仍各有用途:
| 方案 | 主要解决什么 | 零副本时如何恢复 |
|---|---|---|
| 原生 HPA | 根据指标调整工作负载副本数 | 持续读取 Object、External 指标,恢复副本;指标适配和请求缓冲需要另外提供 |
| KEDA | 对接消息队列、数据库等事件源,提供 Scaler、认证和触发器配置 | 在这里参考的 KEDA 2.18 架构中,由 Operator 处理 0↔1,生成的 HPA 处理 1↔N |
| Knative Serving(KPA) | 提供面向 HTTP 服务的自动伸缩和流量接入 | Activator 暂存请求并配合 Autoscaler 唤醒服务,就绪后转发请求 |
如果已经有可靠的 External Metrics 链路,只需要根据队列长度伸缩消费者,可以直接使用原生 HPA。需要方便地接入多种事件源时,KEDA 的 Scaler 和配置能力仍然有价值;需要 HTTP 请求触发唤醒、等待冷启动和转发流量时,Knative Serving 提供的是更完整的服务链路。
3. Demo
环境准备
这里使用 KubeClipper v1.7.0 部署 Kubernetes v1.37.0 单节点集群,安装和创建集群的步骤参考之前的 KubeClipper 1.7.0 发布:Operation 优化与 Kubernetes 1.37 支持。
| |
本次节点 Allocatable CPU 为 8 核,未设置控制平面 NoSchedule 污点。其他规格的环境需要相应调整示例中的 CPU requests。
开启 Gang Scheduling
Gang Scheduling 在 1.37 中进入 Beta,但默认没有开启。需要在控制平面组件中打开 GenericWorkload,同时启用对应的 API。
先备份静态 Pod 配置:
| |
编辑 /etc/kubernetes/manifests/ 下的三个文件,在各自的 spec.containers[].command 参数列表中增加:
| 文件 | 增加的参数 |
|---|---|
kube-apiserver.yaml | --feature-gates=GenericWorkload=true、--runtime-config=scheduling.k8s.io/v1beta1=true |
kube-controller-manager.yaml | --feature-gates=GenericWorkload=true |
kube-scheduler.yaml | --feature-gates=GenericWorkload=true |
例如,kube-apiserver 中的配置如下,其他已有参数保持原样:
| |
保存后 kubelet 会自动重建对应的静态 Pod。等待控制平面组件恢复为 1/1 Running,再次确认实际运行进程的启动参数:
| |
下面只保留进程名和相关参数,其余输出省略:
| |
三个组件的实际运行进程都带有 --feature-gates=GenericWorkload=true,说明开关已在运行的组件中启用。kube-apiserver 还应带有 --runtime-config=scheduling.k8s.io/v1beta1=true。
然后确认对应的 API 也已开放:
| |
| |
资源列表中应能看到 podgroups 和 workloads,API 版本为 scheduling.k8s.io/v1beta1。至此,组件开关和 API 均已确认启用,接下来通过 Demo 验证实际调度效果。
HPA Scale to Zero 在 1.37 中默认开启,无需额外修改
HPAScaleToZero。
Gang Scheduling
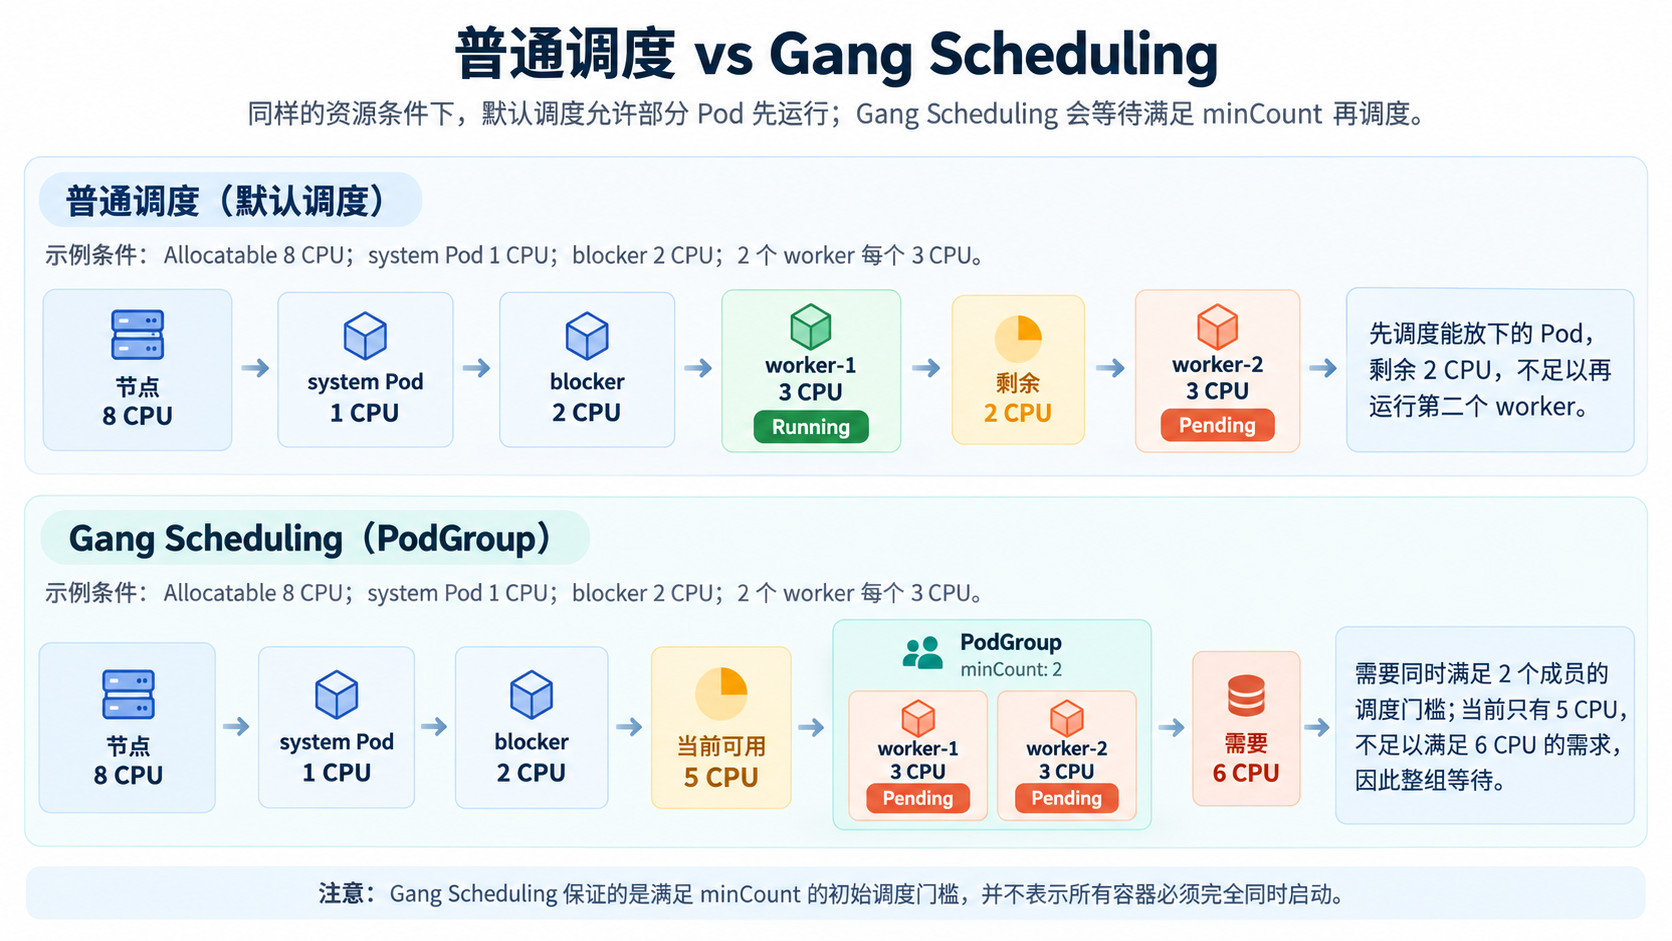
下面通过一个简单示例,对比资源不足时普通调度和 Gang 调度的表现。
普通调度:先启动一部分
为了方便测试调度 Pending 的情况,这里先创建一个占位 Pod,这样剩余资源只能创建一个 Pod 了,便于测试:
| |
确认 blocker 为 Running 后,再创建两个普通 Pod:
| |
稍等后再次查看,可以看到一个 Worker 运行,另一个 Pending:
| |
普通调度会逐个处理 Pod,能放下的先运行,不会等待其他成员。
Gang 调度:资源不足,整组等待
删除刚才的普通 Pod,保留占位 Pod,保证两次实验的资源条件一致:
| |
创建独立的 PodGroup,minCount 要求至少两个成员满足调度条件:
| |
再创建两个 Pod,通过 schedulingGroup.podGroupName 加入这个组。其他配置与普通 Pod 一致:
| |
稍等一会儿再次查看,两个成员都保持 Pending,且都没有绑定节点:
| |
这次成员已经齐全,等待的原因是资源不足。查看 PodGroup 的状态和事件:
| |
PodGroup 明确报告无法调度。即使节点还能容纳一个 Worker,调度器也不会先调度,因为无法满足 minCount: 2,这也正是 Gang 调度的语义。
释放资源,整组调度
删除占位 Pod,再查看两个成员的状态:
| |
稍等后,两个成员都变为 Running:
| |
两次实验的区别就很直观了:普通调度允许部分 Pod 先运行;Gang 调度在无法满足最小成员数时整组等待,资源满足后才推进调度。 这里保证的是初始调度门槛,容器启动仍有先后;成员后续被删除或驱逐时,也不保证运行数量始终满足 minCount。
实验结束后清理:
| |
HPA Scale to Zero
本次 HPA 实验已在 hpa-zero 命名空间预先部署 Redis、Redis Exporter、Prometheus 和 Prometheus Adapter。下面展示关键配置和运行结果,省略基础组件的安装过程。
获取队列指标
简单起见,我们用 Redis List 来保存任务,重点看队列长度怎样传给 HPA。
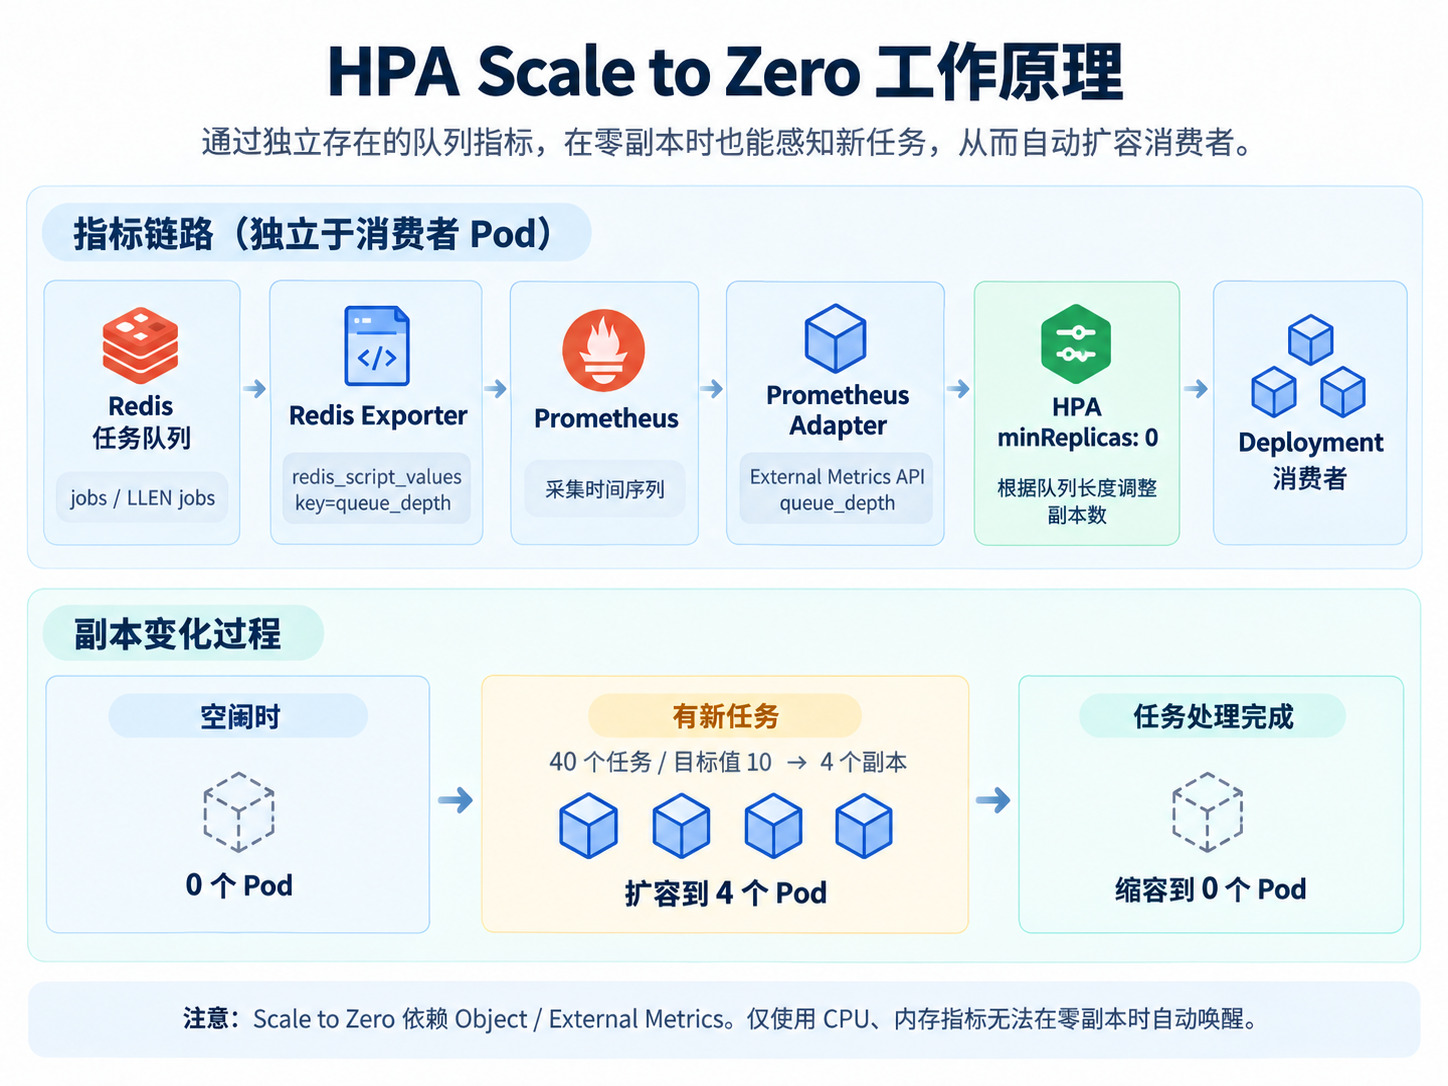
先把队列长度暴露为 Prometheus 指标。 Redis Exporter 通过 --script 加载下面的 Lua 脚本,读取 jobs 队列长度:
| |
这里用 LLEN 直接读取长度,空队列返回 0,避免 List 清空、key 消失后指标也跟着消失。
Prometheus 采集 Exporter,并通过采集配置和 relabel 补上命名空间、队列标签。采集后的指标类似这样,其他标签省略:
| |
再把指标提供给 HPA。 Prometheus Adapter 将这条时间序列映射为 External Metric queue_depth,对应的 Helm Chart values 配置片段如下:
| |
其中 namespace 对应 Kubernetes 命名空间,queue 用来选择队列。查询还检查采集状态和 redis_up,上游失败时不返回有效负载值,不能把“指标读不到”补成零。
最后确认 Kubernetes 能读到指标:
| |
空队列时应返回 value: "0"。如果这条指标不可用,HPA 可能报告 ScalingActive=False / FailedGetExternalMetric,已经归零的消费者也无法自动唤醒。
配置消费者和 HPA
消费者从 Redis 的 jobs 列表取任务,处理后写入 completed 列表,方便核对完成数量。直接创建 Deployment 和 HPA,Deployment 初始为 1 个副本:
| |
这里用 LPOP 模拟消费,仅验证伸缩效果。任务出队后,若 Pod 在处理完成前退出,任务可能丢失;实际业务需要消息确认、失败重投和优雅退出,队列长度也不包含正在执行的任务。
本例使用 Value: 10 验证从零恢复:指标为 40 时,计算出的期望副本数为 4。这不表示始终按“每 10 个任务一个 Pod”伸缩,非零副本时还会考虑 Ready Pod 数量。按每副本平均积压量设置目标,应使用 AverageValue。
为了少等一会儿,把缩容稳定窗口改成了 30 秒,默认是 5 分钟。实际缩容还受指标刷新和 HPA 同步周期影响,不会刚好卡着队列清空后的第 30 秒发生。
从零副本到自动唤醒
先不放任务,看下 HPA:
| |
另一个终端观察消费者:
| |
HPA 会把初始的 1 个消费者缩成 0,等 Pod 全部退出后,查看 Condition:
| |
关键状态如下:
| |
ScaledToZero=True 表示 HPA 自己将副本缩到了零,后续会继续评估指标。手动将 Deployment 缩到零则保留暂停语义,不等同于这次自动归零。
接下来直接放 40 个任务,不用手动启动消费者:
| |
这次 HPA 把期望副本数从 0 调成了 4,消费者启动后开始处理任务。唤醒之后,ScaledToZero 变成 False,Reason 是 NotScaledToZero。
等消费完成,核对一下队列和完成数量:
| |
40 个任务都处理完了。再等缩容稳定窗口过去,消费者重新缩成 0,Pod 全部退出,ScaledToZero 也重新变成 True。
完整过程就是 1 → 0 → 4 → 0:
| 阶段 | 消费者 | 任务状态 |
|---|---|---|
| 空闲 | 自动缩到 0 | 队列为空 |
| 放入 40 个任务 | 起初为 0 | 40 个任务等待处理 |
| HPA 读到新指标 | 扩到 4,随后全部就绪 | 开始消费 |
| 消费完成 | 暂时保留副本 | 队列为 0,完成数为 40 |
| 稳定窗口过后 | 再次自动归零 | 消费者 Pod 全部退出 |
4. 使用上的取舍
Gang Scheduling 和 HPA Scale to Zero 这次两个特性,都是把生态里使用较多的能力进一步补进 Kubernetes 原生体系。简单场景有了更直接的选择,而 Volcano 的队列和资源管理、KEDA 的事件源适配、Knative 的请求接入仍各有用途。是否替换现有方案,还是要看实际需要哪些能力。