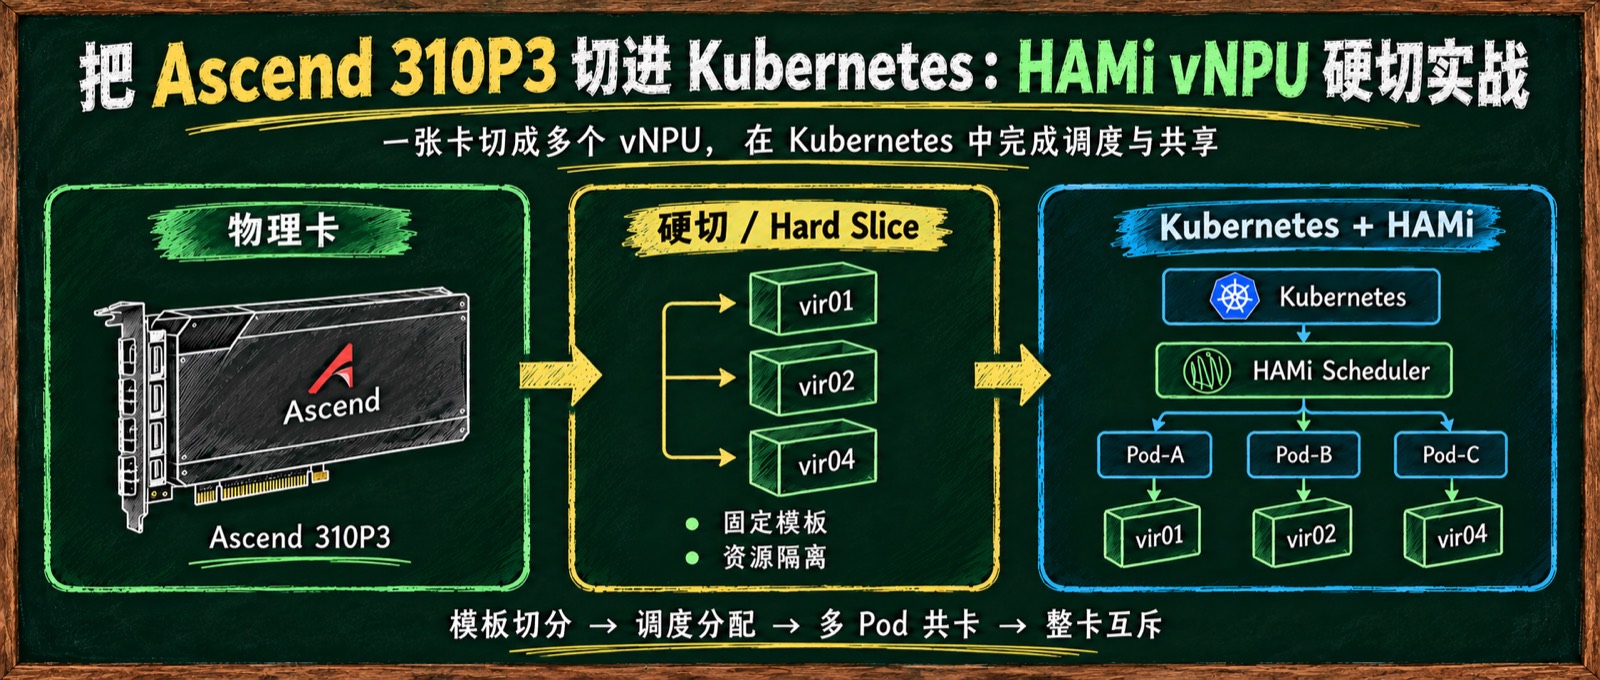
前一篇《Ascend vNPU 实战:从原生 Docker 到 Ascend Docker Runtime》 已经跑通了 vNPU 的两种用法,本文继续把这套能力接进 Kubernetes,用 HAMi 统一管理 vNPU。
310P3 的硬切并不是按任意比例切分显存和算力,而是从芯片支持的固定 vNPU 模板中选择一档。HAMi 会根据 Pod 的资源请求匹配合适的模板,由 Scheduler 选择具体设备并记录分配结果;随后 kubelet 调用 Ascend device-plugin 完成设备分配,最终由 Ascend Runtime 将对应的 vNPU 暴露给容器。
环境准备
实验环境
组件 版本或配置 操作系统 Ubuntu 20.04.6 LTS,x86_64 节点 单节点,lixd-npu-test2 NPU Ascend 310P3,1 张 Kubernetes v1.37.0 HAMi v2.10.0 ascend-device-plugin v1.4.1
版本说明 :本文记录的是 Ascend Driver 22.0.4 环境下的模板硬切分实测。ascend-device-plugin v1.4.1 官方部署文档将 Ascend Driver ≥ 25.5 列为环境要求;本文环境低于该要求,实测结果仅对应本文所述环境,不代表官方支持或推荐的版本组合。
宿主机初始状态如下:
1
2
3
4
5
6
7
8
9
+--------------------------------------------------------------------------------------------------------+
| npu-smi 22.0.4                                   Version: 22.0.4                                       |
+-------------------------------+-----------------+------------------------------------------------------+
| NPU     Name                  | Health          | Power(W)     Temp(C)           Hugepages-Usage(page) |
| Chip    Device                | Bus-Id          | AICore(%)    Memory-Usage(MB)                        |
+===============================+=================+======================================================+
| 7       310P3                 | OK              | NA           28                0    / 0              |
| 0       0                     | 0000:00:07.0    | 0            1805 / 21527                            |
+===============================+=================+======================================================+
安装 HAMi 2.10
添加 HAMi Helm 仓库:
1
2
3
helm repo add hami-charts https://project-hami.github.io/HAMi/
helm repo update
helm search repo hami-charts/hami --versions | head
安装 HAMi 2.10,并开启 Ascend 设备支持:
1
2
3
4
helm install hami hami-charts/hami \
\
\
= true
devices.ascend.enabled=true 开启昇腾资源支持。
安装好后确认 HAMi 调度器已经正常运行:
1
2
3
root@lixd-npu-test2:~# kubectl -n kube-system get pod -l app.kubernetes.io/component= hami-scheduler
NAME READY STATUS RESTARTS AGE
hami-scheduler-7f554bd479-rsrb9 2/2 Running 0 3m33s
标记 Ascend 节点
昇腾的 device-plugin 默认通过 ascend=on 选择节点,因此需要给节点打上 label。
1
kubectl label node lixd-npu-test2 ascend = on --overwrite
部署 RuntimeClass
需要节点上已经装好 Ascend Docker Runtime 并注册了 ascend handler。
然后创建 RuntimeClass:
1
kubectl apply -f https://raw.githubusercontent.com/Project-HAMi/ascend-device-plugin/refs/tags/v1.4.1/ascend-runtimeclass.yaml
部署 ConfigMap
安装 HAMi 后已经自动创建了全局配置 hami-scheduler-device,其中包含 Ascend 的 resourceName、切分模式和 vNPU 模板,不需要重复部署。
后续 device-plugin 还会挂载 hami-device-node-config,因此需要先手动创建节点级 ConfigMap:
1
kubectl apply -f https://raw.githubusercontent.com/Project-HAMi/ascend-device-plugin/refs/tags/v1.4.1/ascend-device-node-configmap.yaml
节点级别的设置优先级高于全局。
部署 ascend-device-plugin
使用 v1.4.1 tag 下的官方 YAML 部署:
1
kubectl apply -f https://raw.githubusercontent.com/Project-HAMi/ascend-device-plugin/refs/tags/v1.4.1/ascend-device-plugin.yaml
v1.4.1 tag 中的 YAML 默认镜像仍然是 v1.4.0,因此部署后手动把 DaemonSet 镜像更新为 v1.4.1:
1
2
3
kubectl -n kube-system set image \
\
= projecthami/ascend-device-plugin:v1.4.1
确认 DevicePlugin 启动成功:
1
2
3
root@lixd-npu-test2:~# kubectl -n kube-system get pod -l app.kubernetes.io/component= hami-ascend-device-plugin
NAME READY STATUS RESTARTS AGE
hami-ascend-device-plugin-2z52v 1/1 Running 0 8m26s
DevicePlugin 启动后,验证节点资源情况:
1
kubectl describe node lixd-npu-test2 | grep "Capacity:" -A 7
1
2
3
4
5
6
7
8
Capacity:
  cpu:                    16
  ephemeral-storage:      100676120576
  huawei.com/Ascend310P:  7
  hugepages-1Gi:          0
  hugepages-2Mi:          0
  memory:                 65866796Ki
  pods:                   110
为什么一张物理卡会显示 huawei.com/Ascend310P:7 ?
节点上出现的 huawei.com/Ascend310P: 7 是 HAMi/device-plugin 按最小 vNPU 模板折算后,向 Kubernetes 上报的可调度资源份额,不代表节点上有 7 张物理 NPU。
当前 310P3 配置中的最小模板是 vir01=3072 MiB,所以计算是 floor(21527 / 3072) = 7。这里使用的是 memoryAllocatable。
因此 device-plugin 会按最小模板折算虚拟设备数量,并向 Kubernetes 上报 Ascend310P: 7;具体 Pod 能否继续分配到这张物理卡,则由 HAMi 结合设备显存等资源进行判断。
HAMi vNPU 资源模型与模板
HAMi 里的资源
310P3 模板硬切使用设备数量和显存两个资源键:
1
2
3
4
resources :
limits :
huawei.com/Ascend310P : "1"
huawei.com/Ascend310P-memory : "1024"
huawei.com/Ascend310P:Ascend 设备数量资源。模板硬切时设置为 1,再结合 -memory 选择 vNPU 模板;huawei.com/Ascend310P-memory:显存请求。HAMi 会选择能够满足请求的最小模板;不指定 -memory 时表示申请整卡。 查看 310P3 支持的模板
查看 NPU 硬件支持的 vNPU 模板:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
root@lixd-npu-test2:~# npu-smi info -t template-info -i 7
+------------------------------------------------------------------------------------------+
| NPU instance template info is: |
| Name AICORE Memory AICPU VPC VENC JPEGD |
| GB PNGD VDEC JPEGE |
| ========================================================================================== |
| vir01 1 3 1 1 0 2 |
| 0 1 1 |
+------------------------------------------------------------------------------------------+
| vir02 2 6 2 3 1 4 |
| 0 3 2 |
+------------------------------------------------------------------------------------------+
| vir02_1c 2 6 1 3 0 4 |
| 0 3 2 |
+------------------------------------------------------------------------------------------+
| vir04 4 12 4 6 2 8 |
| 0 6 4 |
+------------------------------------------------------------------------------------------+
| vir04_3c 4 12 3 6 1 8 |
| 0 6 4 |
+------------------------------------------------------------------------------------------+
| vir04_3c_ndvpp 4 12 3 0 0 0 |
| 0 0 0 |
+------------------------------------------------------------------------------------------+
| vir04_4c_dvpp 4 12 4 12 3 16 |
| 0 12 8 |
+------------------------------------------------------------------------------------------+
然后查看 HAMi 实际加载的 ConfigMap:
1
2
3
kubectl -n kube-system get cm hami-scheduler-device \
jsonpath = '{.data.device-config\.yaml}' \
| grep -A24 'chipName: 310P3'
HAMi 当前针对 310P3 的默认配置只启用了三种模板:
模板 配置显存 AI Core AI CPU vir013072 MiB 1 1 vir026144 MiB 2 2 vir0412288 MiB 4 4
对应配置如下:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
- chipName : 310P3
commonWord : Ascend310P
resourceName : huawei.com/Ascend310P
resourceMemoryName : huawei.com/Ascend310P-memory
resourceCoreName : huawei.com/Ascend310P-core
memoryAllocatable : 21527
memoryCapacity : 24576
aiCore : 8
aiCPU : 7
runtimeClassName : ascend
templates :
- name : vir01
memory : 3072
aiCore : 1
aiCPU : 1
- name : vir02
memory : 6144
aiCore : 2
aiCPU : 2
- name : vir04
memory : 12288
aiCore : 4
aiCPU : 4
Demo 1:单 Pod 申请 1024 MiB
先从最小场景开始,创建一个申请 1024 MiB 显存的 Pod:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
apiVersion : v1
kind : Pod
metadata :
name : auto-1024
spec :
schedulerName : hami-scheduler
runtimeClassName : ascend
restartPolicy : Never
containers :
- name : npu-test
image : docker.io/ascendai/cann:7.0.1-310p-openeuler20.03-py3.8
imagePullPolicy : IfNotPresent
command : [ "bash" , "-lc" ]
args :
- |
echo "ASCEND_VISIBLE_DEVICES=$ASCEND_VISIBLE_DEVICES"
echo "ASCEND_VNPU_SPECS=$ASCEND_VNPU_SPECS"
npu-smi info
sleep 3600
resources :
limits :
huawei.com/Ascend310P : "1"
huawei.com/Ascend310P-memory : "1024"
确认 Pod 已经 Running:
1
kubectl get pod auto-1024 -o wide
1
2
NAME        READY   STATUS    RESTARTS   AGE   IP             NODE
auto-1024   1/1     Running   0          21s   172.25.49.46   lixd-npu-test2
HAMi 把这次请求匹配为 vir01,分配注解如下:
1
2
kubectl get pod auto-1024 \
jsonpath = '{.metadata.annotations.hami\.io/Ascend310P-devices-allocated}{"\n"}{.metadata.annotations.huawei\.com/Ascend310P}{"\n"}'
1
2
E0766E64-20C0E5F1-27941064-AED8030A-F6003019,Ascend310P,3072,0:;
[{"UUID":"E0766E64-20C0E5F1-27941064-AED8030A-F6003019","temp":"vir01","memory":3072}]
进入 Pod 查看环境变量和设备信息:
1
2
3
4
5
kubectl exec auto-1024 -- bash -lc '
  echo "ASCEND_VISIBLE_DEVICES=$ASCEND_VISIBLE_DEVICES"
  echo "ASCEND_VNPU_SPECS=$ASCEND_VNPU_SPECS"
  npu-smi info
'
完整输出:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
ASCEND_VISIBLE_DEVICES=0
ASCEND_VNPU_SPECS=vir01
+--------------------------------------------------------------------------------------------------------+
| npu-smi 22.0.4                                   Version: 22.0.4                                       |
+-------------------------------+-----------------+------------------------------------------------------+
| NPU     Name                  | Health          | Power(W)     Temp(C)           Hugepages-Usage(page) |
| Chip    Device                | Bus-Id          | AICore(%)    Memory-Usage(MB)                        |
+===============================+=================+======================================================+
| 7       310Pvir01             | OK              | NA           28                0    / 0              |
| 0       0                     | 0000:00:07.0    | 0            249  / 2690                             |
+===============================+=================+======================================================+
Pod 已经 Running,ASCEND_VNPU_SPECS=vir01、分配注解里的 temp: vir01 和 Pod 内的 310Pvir01 三处证据也能互相对应,说明最基本的硬切链路正常。
Demo 2:不同显存请求与模板匹配
接下来验证 HAMi 是否真的会按请求自动选择模板。我分别申请 1024、4096 和 7000 MiB,这些值都不是模板的精确显存。
三个 Pod 全部 Running:
1
2
3
4
NAME        READY   STATUS    NODE
auto-1024   1/1     Running   lixd-npu-test2
auto-4096   1/1     Running   lixd-npu-test2
auto-7000   1/1     Running   lixd-npu-test2
匹配结果如下:
原始申请 webhook 调整后 HAMi 选择模板 容器内可见容量 1024 MiB 3072 MiB vir012690 MiB 4096 MiB 6144 MiB vir025381 MiB 7000 MiB 12288 MiB vir0410763 MiB
4096 MiB 请求在 Pod 内显示为 vir02:
1
2
3
4
5
6
ASCEND_VISIBLE_DEVICES=0
ASCEND_VNPU_SPECS=vir02
+===============================+=================+======================================================+
| 7       310Pvir02             | OK              | NA           28                0    / 0              |
| 0       0                     | 0000:00:07.0    | 0            497  / 5381                             |
+===============================+=================+======================================================+
7000 MiB 请求在 Pod 内显示为 vir04:
1
2
3
4
5
6
ASCEND_VISIBLE_DEVICES=0
ASCEND_VNPU_SPECS=vir04
+===============================+=================+======================================================+
| 7       310Pvir04             | OK              | NA           29                0    / 0              |
| 0       0                     | 0000:00:07.0    | 0            995  / 10763                            |
+===============================+=================+======================================================+
宿主机同时看到三个 vNPU:
1
2
3
4
5
6
7
8
| Total number of vnpu: 3                                                       |
+-------------------------------------------------------------------------------+
|  Vnpu ID  |  Vgroup ID     |  Container ID  |  Status  |  Template Name       |
+-------------------------------------------------------------------------------+
|  100      |  0             |  ffffffffffff  |  1       |  vir01               |
|  101      |  1             |  ffffffffffff  |  1       |  vir02               |
|  102      |  2             |  ffffffffffff  |  1       |  vir04               |
+-------------------------------------------------------------------------------+
这说明 HAMi 会选择能够满足请求的最小模板。
admission webhook 还会把 Pod 里的显存值改成选中模板的配置值,因此 Pod 创建后再执行 kubectl get pod -o yaml,看到的是 3072/6144/12288。
模板配置显存与容器中 npu-smi 显示的可用容量并不完全相等,这是 Ascend vNPU 自身的保留开销。
Demo 3:超过最大模板后的整卡回退——以 13000 MiB 为例
310P3 最大模板是 vir04=12288 MiB。删除前面的切片并确认 NPU 空闲后,我又申请了 13000 MiB:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
apiVersion : v1
kind : Pod
metadata :
name : over-max-memory-idle-card
spec :
schedulerName : hami-scheduler
runtimeClassName : ascend
restartPolicy : Never
containers :
- name : npu-test
image : docker.io/ascendai/cann:7.0.1-310p-openeuler20.03-py3.8
command : [ "bash" , "-lc" ]
args :
- env | grep -E 'ASCEND|NPU' | sort; npu-smi info; sleep 300
resources :
limits :
huawei.com/Ascend310P : "1"
huawei.com/Ascend310P-memory : "13000"
Pod 成功调度并运行:
1
2
3
4
5
pod/over-max-memory-idle-card created
pod/over-max-memory-idle-card condition met

NAME                        READY   STATUS    RESTARTS   AGE     IP             NODE
over-max-memory-idle-card   1/1     Running   0          3m15s   172.25.49.59   lixd-npu-test2
再看 API Server 中保存的资源和 HAMi 分配注解,原始的 13000 MiB 已经被 webhook 提升为整卡可调度显存 21527 MiB:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
{
"allocated" : "E0766E64-20C0E5F1-27941064-AED8030A-F6003019,Ascend310P,21527,0:;" ,
"device" : "[{\"UUID\":\"E0766E64-20C0E5F1-27941064-AED8030A-F6003019\",\"memory\":21527}]" ,
"resources" : {
"limits" : {
"huawei.com/Ascend310P" : "1" ,
"huawei.com/Ascend310P-memory" : "21527"
},
"requests" : {
"huawei.com/Ascend310P" : "1" ,
"huawei.com/Ascend310P-memory" : "21527"
}
}
}
Pod 内没有 ASCEND_VNPU_SPECS,npu-smi info 看到的是完整的物理 310P3:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
ASCEND_AICPU_PATH=/usr/local/Ascend/ascend-toolkit/latest
ASCEND_DOCKER_RUNTIME=True
ASCEND_HOME_PATH=/usr/local/Ascend/ascend-toolkit/latest
ASCEND_OPP_PATH=/usr/local/Ascend/ascend-toolkit/latest/opp
ASCEND_TOOLKIT_HOME=/usr/local/Ascend/ascend-toolkit/latest
ASCEND_VISIBLE_DEVICES=0
+--------------------------------------------------------------------------------------------------------+
| npu-smi 22.0.4                                   Version: 22.0.4                                       |
+-------------------------------+-----------------+------------------------------------------------------+
| NPU     Name                  | Health          | Power(W)     Temp(C)           Hugepages-Usage(page) |
| Chip    Device                | Bus-Id          | AICore(%)    Memory-Usage(MB)                        |
+===============================+=================+======================================================+
| 7       310P3                 | OK              | NA           28                0    / 0              |
| 0       0                     | 0000:00:07.0    | 0            1805 / 21527                            |
+===============================+=================+======================================================+
宿主机同时显示 Total number of vnpu: 0。所以 13000 MiB 并没有匹配到一个更大的 vNPU,而是被转换成整卡申请。空闲卡上可以运行;卡上已有切片时,同样的请求会因 CardInsufficientMemory 保持 Pending。
Demo 4:多 Pod 共卡与容量耗尽
单 Pod 跑通只能证明链路没断,真正使用时更关心多个任务能不能共卡。
两个 vir01 Pod 同时运行时,HAMi 给出的物理设备 UUID 相同,两个容器内都看到独立的 310Pvir01。随后我把 Deployment 副本数调到 8,每个副本都申请一个 vir01。
结果很直接:
1
2
NAME                      READY   UP-TO-DATE   AVAILABLE
hami-310p-oversubscribe   7/8     8            7
7 个 Pod Running,第 8 个一直 Pending:
1
2
Warning  FailedScheduling  hami-scheduler
0/1 nodes are available: 1 1/1 CardTimeSlicingExhausted.
宿主机也正好看到 7 个 vir01:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
| Total number of vnpu: 7                                                       |
+-------------------------------------------------------------------------------+
|  100      |  0             |  ffffffffffff  |  1       |  vir01               |
|  101      |  0             |  ffffffffffff  |  1       |  vir01               |
|  102      |  1             |  ffffffffffff  |  1       |  vir01               |
|  103      |  1             |  ffffffffffff  |  1       |  vir01               |
|  104      |  2             |  ffffffffffff  |  1       |  vir01               |
|  105      |  2             |  ffffffffffff  |  1       |  vir01               |
|  106      |  3             |  ffffffffffff  |  1       |  vir01               |
+-------------------------------------------------------------------------------+
这里同时验证了 Kubernetes 上报的 Ascend310P: 7 确实对应七个最小模板,以及容量用尽后 HAMi 会给出明确的 CardTimeSlicingExhausted,而不是把第 8 个 Pod 错误绑到节点。
Demo 5:整卡与切片双向互斥
不设置 huawei.com/Ascend310P-memory 就表示申请整卡:
1
2
3
resources :
limits :
huawei.com/Ascend310P : "1"
webhook 会自动补成整卡可调度显存:
1
huawei.com/Ascend310P-memory : "21527"
我把两个方向都测了一遍。
整卡 Pod 先运行,再创建 vir01 切片,切片 Pod Pending:
1
0/1 nodes are available: 1 1/1 CardInsufficientMemory.
反过来,vir01 + vir02 + vir04 已经运行时再申请整卡,整卡 Pod 同样 Pending:
1
2
3
4
5
6
7
8
NAME                 READY   STATUS
auto-1024            1/1     Running
auto-4096            1/1     Running
auto-7000            1/1     Running
whole-after-slices   0/1     Pending

Warning  FailedScheduling  hami-scheduler
0/1 nodes are available: 1 1/1 CardInsufficientMemory.
所以整卡与切片的互斥在 HAMi 2.10 上仍然成立,调度器会通过设备显存记账阻止两类工作负载同时使用同一张卡。
一个容易踩的坑:残留 vNPU
这一步第一次跑的时候,8 个 vir01 只有 3 个真的跑起来,另外 4 个一直 CrashLoopBackOff,容器根本没启动:
1
2
failed to create containerd task: ... /usr/local/Ascend/Ascend-Docker-Runtime/ascend-docker-runtime
did not terminate successfully: exit status 1
调度器认为卡是空的(前一步的 Pod 都删掉了),但硬件上并不是。原因是这个驱动上删除 Pod 不一定会立刻释放 vNPU,上一步"超过模板转整卡"的 Pod 在卡上留了一个 vir04 实例:
1
2
3
4
5
6
| Total number of vnpu: 4                                                       |
|  Vnpu ID  |  Vgroup ID     |  Container ID  |  Status  |  Template Name       |
|  100      |  0             |  000000000000  |  0       |  vir01               |
|  101      |  0             |  000000000000  |  0       |  vir01               |
|  102      |  2             |  000000000000  |  0       |  vir04               |  <- 残留
|  103      |  1             |  000000000000  |  0       |  vir01               |
残留的 vir04 占掉 12 GiB,卡上只剩 2 GiB 可用,所以第 4 个 vir01 开始就创建失败。判断方法是对比两个视角:npu-smi info -t info-vnpu 里 Container ID 是 000000000000 的条目就是没人认领的残留实例,而 npu-smi info 的剩余显存会明显低于 HAMi 仍在播报的容量。
清理方式是重启设备插件触发它的空闲 vNPU 回收,或者直接销毁:
1
2
kubectl -n kube-system rollout restart daemonset/hami-ascend-device-plugin
npu-smi set -t destroy-vnpu -i 7 -c 0 -v VNPU_ID
清理干净后重跑,结果就和预期一致:7 个 vir01 全部 Running,第 8 个 Pending,卡上正好 7 个 vir01 实例。所以每一步之间先删掉上一步的 Pod 并等 vNPU 释放,否则下一步看起来就像容量算错了。
Demo 6:Pod 内运行真实 AscendC 负载
显存实际分配与释放
前面的 Pod 都只运行 npu-smi 和 sleep,最多证明设备能创建出来。
为了确认 vNPU 里真的可以使用显存,我在 vir04 容器中通过 ACL 初始化设备并申请约 6 GiB 内存。空闲时 Pod 内看到:
1
2
| 7       310Pvir04             | OK              | NA           33                0    / 0              |
| 0       0                     | 0000:00:07.0    | 0            995  / 10763                            |
分配期间变成:
1
2
3
4
+===============================+=================+======================================================+
| 7       310Pvir04             | OK              | NA           33                3092 / 3092           |
| 0       0                     | 0000:00:07.0    | 0            10763/ 10763                            |
+===============================+=================+======================================================+
释放后又恢复到:
1
2
| 7       310Pvir04             | OK              | NA           33                0    / 0              |
| 0       0                     | 0000:00:07.0    | 0            995  / 10763                            |
这个结果证明 ACL 工作负载可以在 vir04 内分配和释放设备内存,也说明该 vir04 容器中的设备视图和显存分配受对应 vNPU 容量约束。
宿主机物理卡的 Memory-Usage 没有按相同幅度增长,因此不能用宿主机这一个字段反推单个硬切 Pod 的实时显存。310P3 旧驱动下,vNPU 内部统计、HugePages 和物理卡统计的口径并不相同。
编译并运行 CANN 自带的 AscendC 基础算子
显存能申请还不够,我又在同一个 vir04 中编译并运行了 CANN 自带的 AscendC 基础算子。
构建过程生成了 AI Core 目标文件并完成链接:
1
2
3
4
[100%] Building CXX object ... auto_gen_add_custom.cpp.o
[100%] Building CXX object ... auto_gen_matmul_custom.cpp.o
/usr/local/Ascend/ascend-toolkit/latest/compiler/ccec_compiler/bin/ld.lld -m aicorelinux ...
[100%] Built target main
加法算子输出:
1
2
output of add_custom:
8.000000 8.000000 8.000000 8.000000 ...
矩阵乘算子输出:
1
2
output of matmul:
8192.000000 8192.000000 8192.000000 8192.000000 ...
循环运行期间,宿主机采样到过 20% 的 AICore 利用率:
1
2
3
4
5
20:51:39.865
| 7       310P3                 | OK              | NA           34                20   / 20             |

20:51:41.424
| 7       310P3                 | OK              | NA           34                0    / 0              |
这是短算子脉冲负载,所以采样值在 0% 和 20% 之间跳动。它能证明任务确实进入 AI Core 执行,不能据此宣称 vir04 始终占用固定百分比算力。
Demo 7:HAMi 调度侧监控与资源分配指标
HAMi scheduler 容器内部监听 9395,Service 通过 NodePort 31993 暴露 Prometheus 指标:
1
2
curl -s http://NODE_IP:31993/metrics \
  | grep -E 'hami_(gpu_shared_count|vgpu_memory_allocated_bytes|resource_quota_used)'
三个模板同时运行时:
1
2
3
4
5
6
7
8
9
hami_gpu_shared_count{
  device_type="Ascend310P",
  node="lixd-npu-test2"
} 3

hami_resource_quota_used{
  namespace="hami-hard-slice-test",
  quota_name="huawei.com/Ascend310P-memory"
} 21504
Pod 维度的分配量也能看到:
1
2
3
hami_vgpu_memory_allocated_bytes{pod="auto-1024",namespace="hami-hard-slice-test"} 3.221225472e+09
hami_vgpu_memory_allocated_bytes{pod="auto-4096",namespace="hami-hard-slice-test"} 6.442450944e+09
hami_vgpu_memory_allocated_bytes{pod="auto-7000",namespace="hami-hard-slice-test"} 1.2884901888e+10
这三个值分别是 3072、6144 和 12288 MiB 换算成字节后的结果,属于调度分配量 ,不是 Pod 的实时使用量。
小结
这次在 Ascend 310P3 上,从 HAMi 2.10、ascend-device-plugin v1.4.1 到 Pod 内运行 AscendC,完整走通了模板硬切链路。
使用上也比较简单,只需要通过 -memory 指定显存,HAMi 就会自动匹配满足条件的最小 vNPU 模板。
 意琦行 收录于 Kubernetes AI