VLLM 多副本如何复用 KV Cache?llm-D 缓存感知路由实战
 意琦行
上一篇 PD 分离详解:Prefill 与 Decode 的瓶颈、拆分与代价 介绍了为什么要把 Prefill 和 Decode 拆开, vLLM PD 分离实战:从请求流程理解 Prefill、Decode 与 KV Cache 传输 则用一个 P、一个 D 和轻量 Proxy,跑通了请求编排与 KV Cache 传输。
完成 Prefill 和 Decode 解耦之后,可以根据场景单独扩缩容 P、D 实例。
不过多副本推理还需要考虑缓存局部性:当多个实例都开启了前缀缓存,每次请求应该交给谁,才能复用已经计算过的 KV Cache?
本文便基于这个缓存局部性问题展开,通过 llm-d Router 对比随机路由与前缀感知路由。
本文通过两个 vLLM 副本,对比随机路由与前缀感知路由,观察请求选点对缓存命中、Prefill 计算量和首字延迟的影响。
1. 为什么需要缓存感知路由?
Prefix Cache
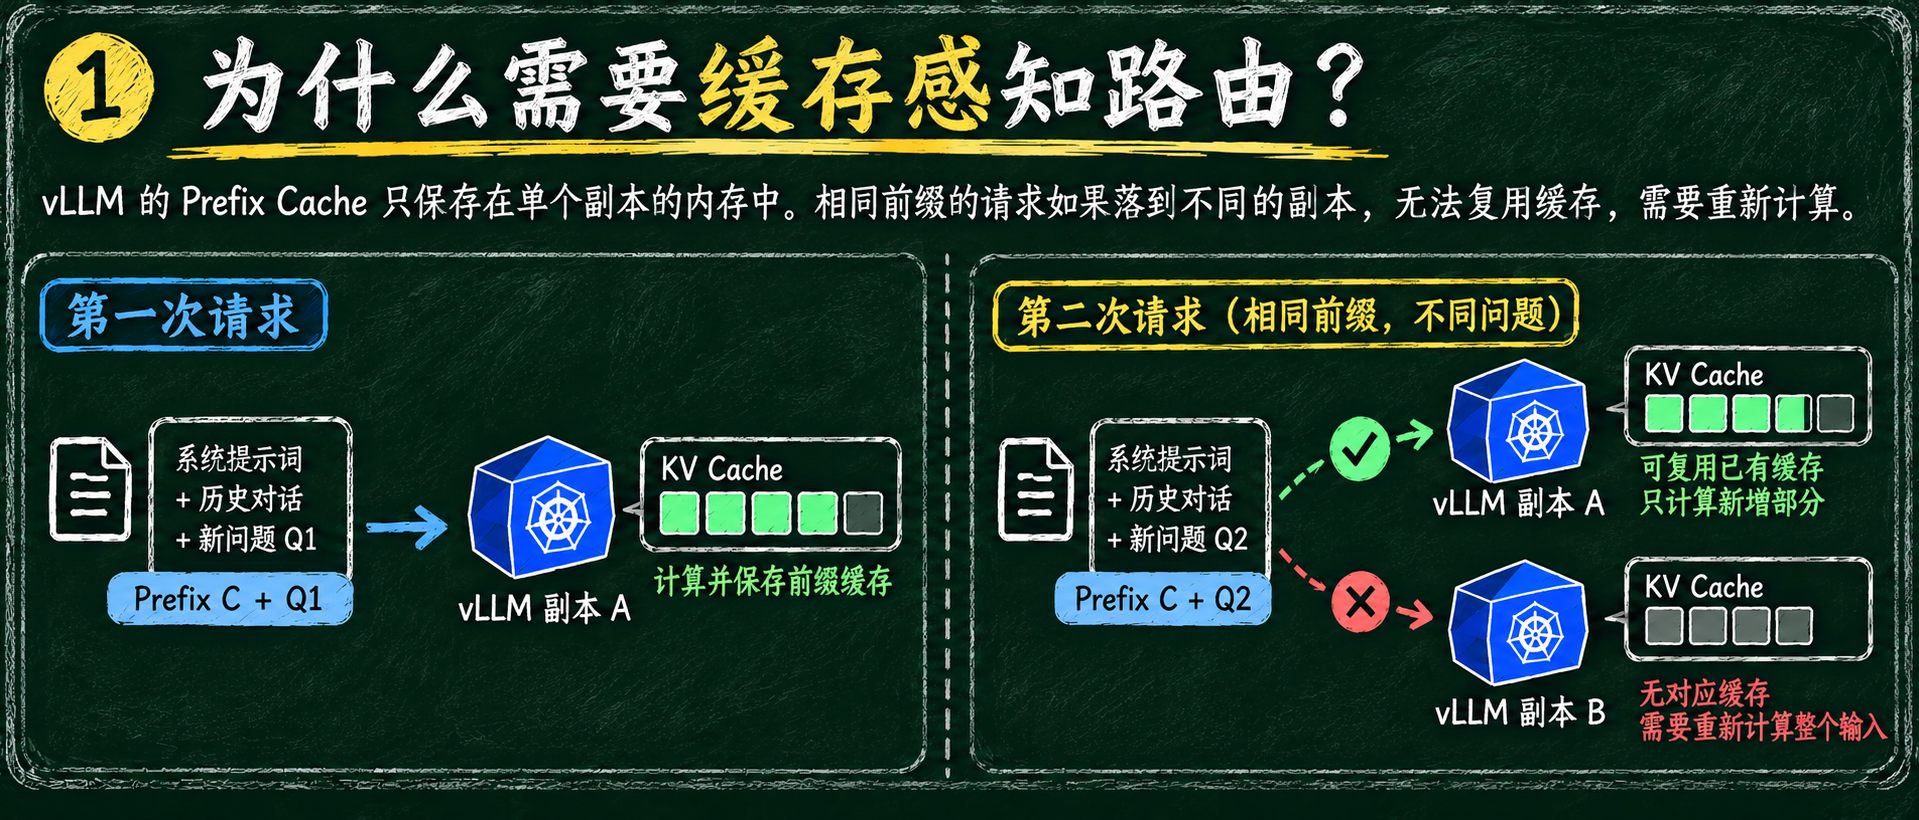
vLLM 的 Automatic Prefix Caching(APC,自动前缀缓存)可以减少重复计算。两次请求包含相同的上下文前缀,就可以复用前缀对应的 KV Cache,减少 Prefill 计算。
但这里有一个前提,两次请求要落到相同的实例,才能用到缓存。
假设第一次请求分给实例 A,A 完成 Prefill 并保留了该上下文前缀对应的 KV Cache。第二次请求如果仍然分给 A,就有机会复用;如果分给 B,B 没有这份缓存,还是需要重新计算。
多副本路由策略
APC 负责单个实例内的缓存复用,多副本之间还需要路由配合。
常见的路由方式有以下几种:
- 轮询或随机路由:不看请求内容,后续请求可能分到没有对应缓存的副本。
- 会话粘滞:让同一会话尽量回到原副本,但不同会话也可能共享相同的系统提示词或其他上下文前缀,而且同一会话的缓存也可能已经被驱逐。
- 前缀感知路由:根据请求前缀的匹配情况,优先选择可能已有缓存的副本。
本文主要验证第三种方式。为了先看清缓存复用的效果,测试时全局并发设为 1,暂时不叠加负载评分。
为了把路由效果单独看清,我们使用两个普通 vLLM 副本做实验,不把它与 PD 分离的传输开销混在一起。
与 PD 分离的关系
前面的 PD Demo 只有一个 P 和一个 D,实例地址确定后,请求按顺序执行即可。扩展到多副本,Router 就需要分别考虑 Prefill 与 Decode 的选择。
| 选择对象 | 需要考虑的问题 |
|---|---|
| Prefill 实例 | 哪个实例保有可复用前缀,可以少做多少 Prefill,以及需要排队多久 |
| Decode 实例 | 哪个实例有足够的 KV 容量、负载是否合适,以及取得所需 KV 的传输成本 |
例如,上下文前缀对应的 KV Cache 已保留在 P1 上,下一次请求如果分给没有对应缓存的 P2,就可能重新计算整个输入;如果只命中部分前缀,则只需要计算剩余部分。
PD 分离不会自动让所有 P 实例共享前缀缓存。
Decode 侧则不能简单理解为“需要拉取缓存就是选错了 D”。P → D 的 KV 传输本来就是分离后的正常步骤。若某个 D 已保有可复用前缀,并且当前缓存与 Connector 实现支持相应复用,选点可能影响需要补齐的 KV 数量;同时还要考虑排队和显存容量。
PD 分离拆开计算阶段,缓存感知路由则在同类候选实例之间选点。 两者可以组合,也可以分别使用。
2. KV Cache 感知路由原理
llm-d Router 的请求处理流程
这里使用 llm-d-router 的 Standalone 模式,主要包含两个组件:
- Envoy:接收客户端请求,并转发到选中的 vLLM 实例。
- Endpoint Picker(EPP):根据请求内容和候选实例信息,决定本次请求发给哪个实例。
请求处理流程如下:
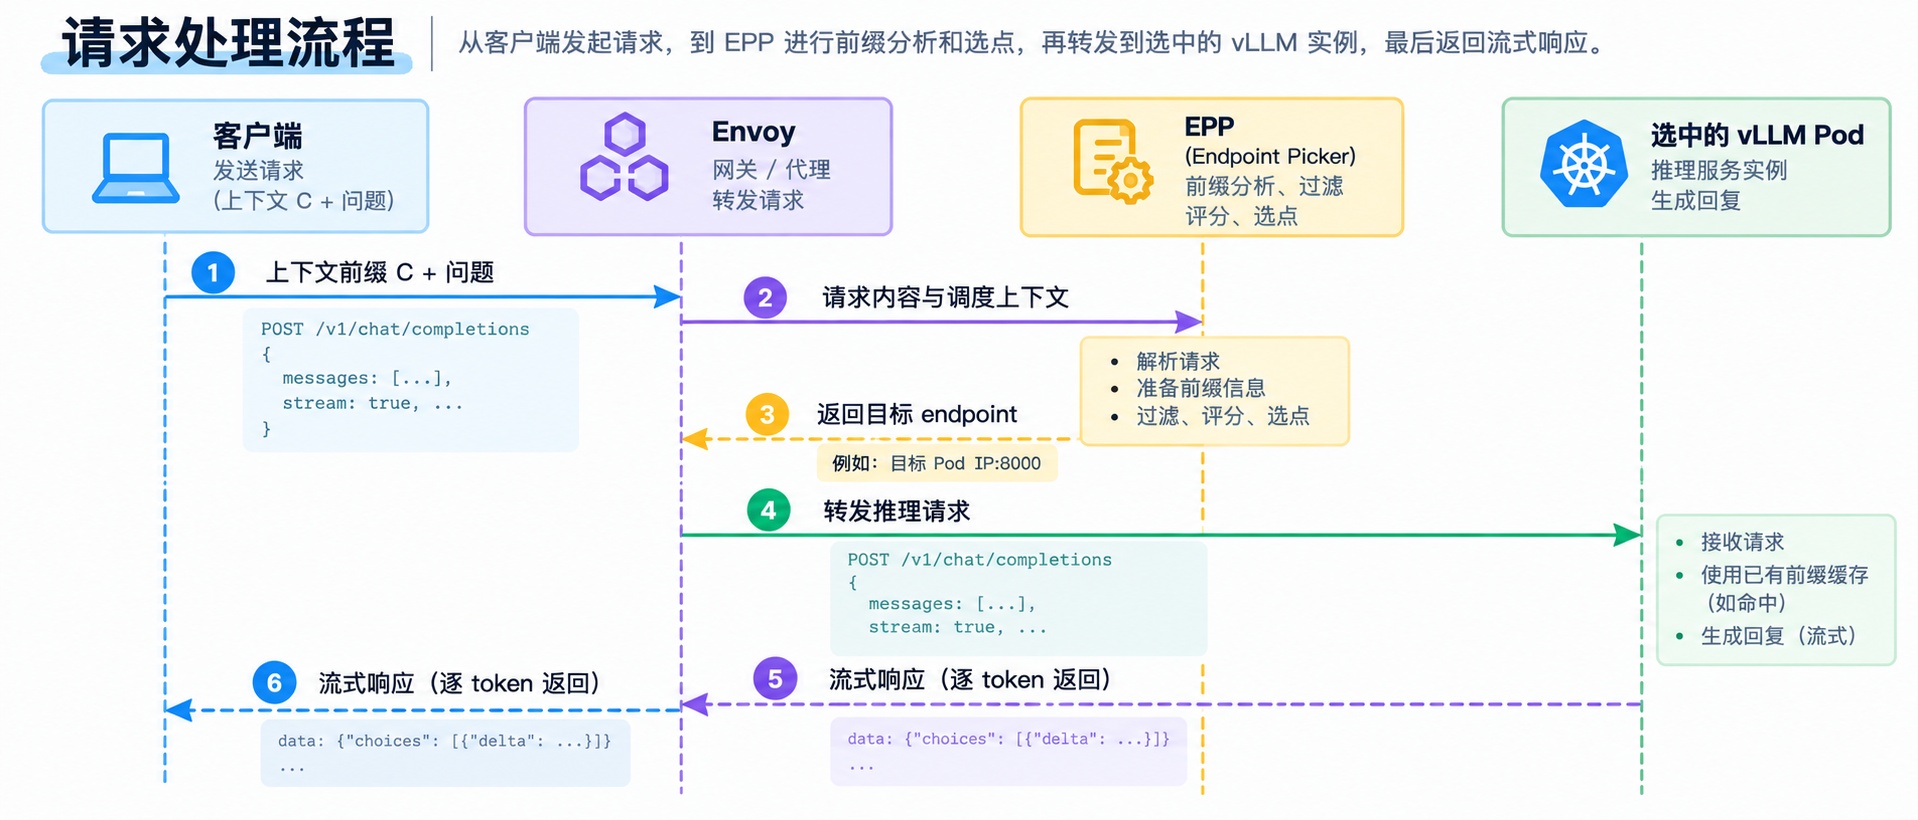
EPP 中和前缀感知相关的处理,可以分成三步:
- 准备前缀信息:
approx-prefix-cache-producer根据请求前缀和历史路由记录,查找哪些副本可能缓存了相同内容。 - 计算评分:
prefix-cache-scorer根据前缀匹配信息,为候选副本打分。v1.0.0 默认使用匹配块占比。 - 选择实例:
max-score-picker选择评分更高的副本;分数相同时,使用轮转方式处理同分候选。
Router 优先选择可能已有缓存的实例,实际能否复用仍然由 vLLM 决定。这里没有跨实例传输 KV Cache,也不涉及 PD 分离。
缓存感知路由的实现思路
不同项目的实现各有差异,但都需要解决:Router 如何知道缓存在哪里这个问题。下面以 llm-d 为例介绍。
常见思路包括根据历史请求估算、根据引擎上报的缓存事件维护索引以及将突发到达、共享前缀的请求集中分配到同一实例。
Approximate:根据历史路由记录估算
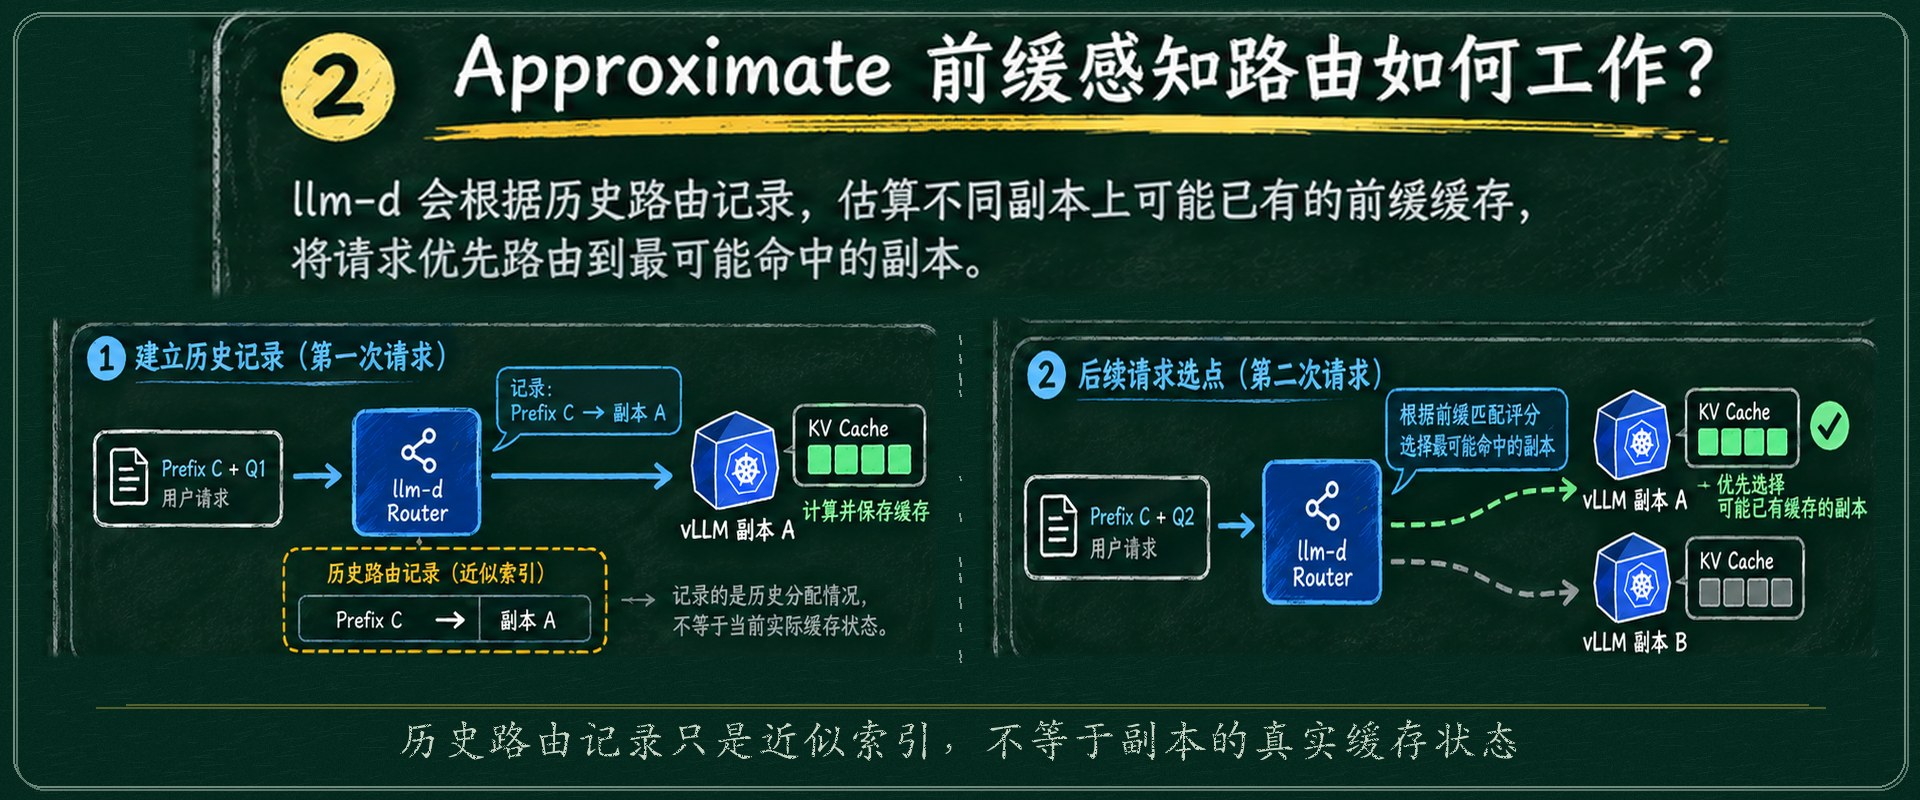
approx-prefix-cache-producer 会将请求的上下文前缀划分成块,维护这些前缀块与实例之间的对应关系。
例如,第一次请求被分配给实例 A 后,Router 就记录该请求的上下文前缀与 A 的关联。后续请求包含相同前缀时,插件便能查询这些记录,推测 A 上可能保留着对应的 KV Cache,并将匹配信息交给后续评分和选点插件,让 A 更容易被选中。
这里记录的是请求的历史分配情况,没有向推理引擎确认缓存是否仍然存在,因此属于近似估算。
这种方式部署比较简单,不依赖引擎上报 KV Events。但记录的是历史的路由选择,不是推理引擎的实际缓存清单;如果缓存已经被驱逐,或者实例重启了,估算就可能与实际状态不符。
Precise:根据引擎事件跟踪缓存状态
precise-prefix-cache-producer 则是订阅引擎的 KV Events,根据缓存块保存、驱逐等事件维护索引。收到新请求后,使用请求上下文对应的真实 token 序列查询索引,判断各实例持有哪些可复用的前缀块。
例如,实例 A 上某段上下文前缀的 KV Cache 被驱逐后, Router 收到缓存驱逐事件,然后去更新索引,移除对应的缓存记录。
注意:Precise 也需要处理事件延迟、丢失以及索引重建等问题。
Burst Prefix:将共享前缀的请求集中起来
还有一种情况:突然有许多共享相同上下文前缀的请求到达,但所有实例都还没有缓存。此时就没有可供优先选择的热实例,那么这些请求可能会被分散到多个副本,分别计算同一段前缀。
burst-prefix-cache-producer 会在一个短时间窗口内收集请求,将上下文相同的请求分组,并根据配置条件,尽量把共享上下文前缀的请求分配到同一实例,减少重复的前缀计算。
它解决的是冷缓存场景下的请求调度问题,收集请求的窗口会增加等待时间,也不保证所有并发请求只计算一次前缀。
前缀匹配信息是选点的依据之一,实际路由还可以结合实例负载、缓存容量等因素。
本文先只考虑前缀复用:由 Approximate 估算各实例的缓存匹配情况,交给 prefix-cache-scorer 评分,再对比随机选择和按评分选择的效果。
3. 实验环境与部署配置
实验环境
本次测试环境如下:
| 项目 | 配置 |
|---|---|
| Kubernetes | v1.36.1,单节点,8 vCPU、约 15 GiB RAM |
| 模型 | Qwen2.5-0.5B-Instruct,同一份本地模型文件 |
| vLLM | v0.31.0,FP16、eager、APC 开启 |
| Router | llm-d-router v1.0.0,Standalone EPP + Envoy v1.33.2 |
| 请求 | 约 5200 token 上下文前缀,输出上限 32 token,全局并发 1 |
配置两个 vLLM 副本
两个副本使用相同的模型和推理参数,各自维护独立的 KV Cache。
将模型挂载到 /model,两个 vLLM 使用以下参数启动:
| |
其中,--enable-prefix-caching 用于开启 APC,--kv-cache-memory-bytes 将每个实例的 KV Cache 预算固定为 256 MiB。本次启动日志显示,每个实例的 GPU KV Cache 容量为 21840 token。
KV Cache 预算和进程总显存不是一回事,模型权重等内容还需要额外占用显存。
配置 Router 后端发现与请求入口
两个 vLLM Pod 都带上 app: kv-demo 标签,Standalone Router 根据标签发现后端,直接访问 Pod 的 8000 端口。核心 Helm values 如下:
| |
配置前缀评分与实例选择
对比两种路由策略:
- 随机路由:使用
random-picker,忽略缓存评分,随机选择实例。 - 前缀感知路由:使用
max-score-picker,按照前缀缓存评分选择实例。
前缀感知路由的 EPP 配置如下:
| |
测试随机路由时,将配置中的两处 max-score-picker 替换为 random-picker 即可。
另外,需要避免正常实例被意外排除。utilization-detector 会检查实例指标的更新时间:如果指标太旧,就可能认为实例状态不可靠,暂时不让它参与选点。
本次指标每 1 秒刷新一次,但默认过期阈值为 200 ms,这里将过期阈值调整为 5 秒。
4. 实验设计与结果分析
测试请求与执行方法
如果一直重复发送相同的长上下文前缀,随机路由也可能把两个副本都预热。等到两个副本上都有缓存,无论请求分给谁都能命中,自然就看不出差异了。
因此,这里基于每段新的上下文前缀构造一对请求:
- 构造上下文前缀 C,约 5200 token,开头带独立 ID,内容由多条不同的运维观察记录组成。
- 发出
C + Summarize the observations.,等待完整响应。 - 保持上下文前缀 C 完全不变,末尾换成
Which measurements should engineers collect next?,再次请求同一个 Router。 - 换一段新的上下文前缀,重复上述步骤。
两次请求的结构如下。context_prefix 表示两次请求共享的上下文前缀,实验脚本会先把它展开成实际文本,再发送 JSON;这里省略约 5200 token 的正文:
| |
两次都请求 /v1/chat/completions,并使用相同的生成参数:
| |
每组测试包含两次请求:第一次发送一段新的上下文前缀和问题 1;响应完成后,保持前缀不变,只把末尾换成问题 2。重点观察第二次请求是否回到原来的实例,以及是否真正复用了缓存。
本实验未启用会话亲和性插件。每条请求使用独立的
X-Request-Id,用于关联 Router 日志与请求记录。
同一轮中,两种策略使用完全相同的 10 组上下文前缀;不同轮使用新的前缀集合。三轮执行顺序依次为“随机 → 前缀感知”“前缀感知 → 随机”“随机 → 前缀感知”。 每次切换策略前,都清空两个 vLLM 实例的前缀缓存,并重建 Router 的缓存索引,避免受上一组测试留下的记录影响。
观察指标与统计口径
我们先通过 request_id 关联 EPP 选中的 endpoint,再找到对应的 vLLM Pod 的请求成功计数和缓存指标增量。
主要观察以下指标:
| |
这些值都是引擎的累计指标,需要取请求前后的增量。全局并发为 1 时,只有一个副本的 request_success_total 增加,便可据此核对本次实际处理请求的实例。
前缀 token 命中率使用 Δhits / Δqueries;多条请求汇总时,先分别累加 hits 和 queries,再计算比例。它与“第二次请求回到首次副本的比例”是两个指标:回到同一副本不保证缓存仍在,换了副本也可能命中通用模板。
实际 Prefill token 数通过 histogram 的 _sum 增量观察。Router 的评分只说明选点依据,vLLM 的命中与实际计算量才说明缓存有没有被复用。
TTFT(Time To First Token) 表示从客户端发起请求,到收到第一个非空 delta.content 的时间。流式响应开头的 role 或空事件不算首字。
测试结果
每种策略执行 3 轮,每轮 10 对请求,共 120 条主实验请求。下表汇总每对请求中的第二次请求,每种策略各 30 条:
| 指标 | 随机路由 | 前缀感知路由 |
|---|---|---|
| 回到首次处理该前缀的副本 | 17/30(56.7%) | 30/30(100%) |
| 前缀 token 命中率 | 56.56% | 99.60% |
| TTFT P50 | 155.1 ms | 127.3 ms |
| TTFT P95 | 2018.0 ms | 159.2 ms |
| 实际 Prefill token 均值 | 2261.5 | 21.0 |
随机组有 17 次请求回到了首次处理该前缀的副本,这部分请求同样很快,TTFT 中位数为 132.2 ms。另外 13 次落到冷副本,中位数则为 2005.3 ms。
前缀感知路由的主要收益来源于减少请求落到冷副本后产生的重复 Prefill。
随机路由中仍有一半左右的后续请求回到了首次处理该前缀的副本,这部分请求同样有机会复用缓存,因此两种策略的 TTFT P50 仅相差约 28 ms。更明显的变化在 P95,从 2018.0 ms 降到了 159.2 ms,而不是所有请求都快了十几倍。
结果的适用范围
缓存命中率高,不一定就代表请求延迟更低。
实际场景可能出现另一种情况,实例 A 有缓存,但队列已经很长;实例 B 没有缓存,却可以马上开始计算。此时就需要比较,复用缓存省下的 Prefill 时间,能不能抵消额外排队的时间。
在这类场景下,前缀评分还需要和负载感知配合使用。会话粘滞可以保持同一会话的亲和性,前缀匹配可以处理跨会话复用,而热点和并发场景还需要结合实例队列等负载信息做判断。
5. 小结
APC 和前缀感知路由解决的是两个层次的问题:
- APC 让单个 vLLM 实例复用已经计算过的前缀。
- 前缀感知路由让请求尽量找到已经有缓存的实例。
本次通过两个 vLLM 副本验证了这个过程。随机路由的 30 次后续请求中,有 17 次回到首次处理该前缀的副本;前缀感知路由则是 30 次全部回到首次处理该前缀的副本,前缀 token 命中率从 56.56% 提升到了 99.60%。
从实际 Prefill token 和 TTFT 也可以看到,请求回到已有缓存的实例后,确实减少了重复计算。对于长上下文前缀、共享提示词等存在前缀复用的场景,可以通过缓存感知路由,提高多副本部署下的缓存复用率,减少重复 Prefill。