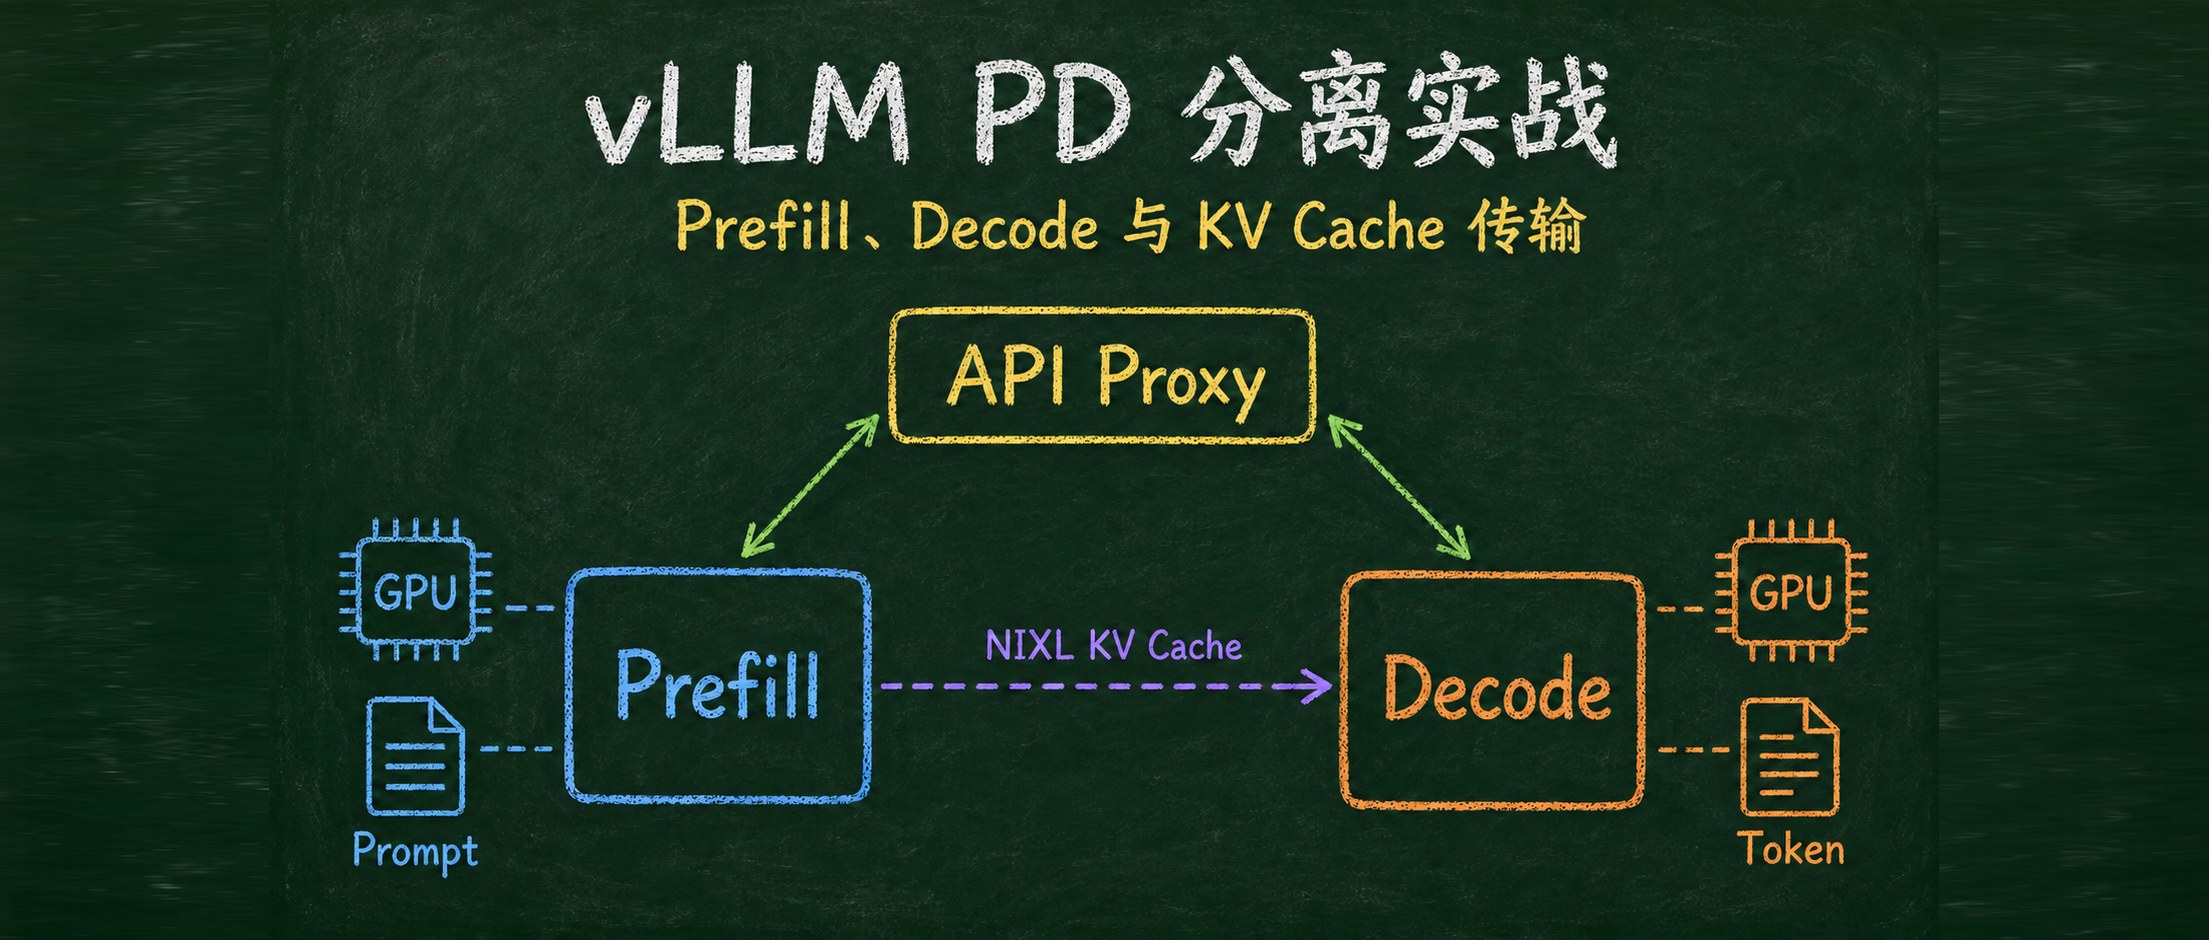
VLLM PD 分离实战:从请求流程理解 Prefill、Decode 与 KV Cache 传输
vLLM PD 分离实战:Prefill、Decode 与 KV Cache 传输

上一篇 https://www.lixueduan.com/posts/ai/27-why-pd-disaggregation/ 介绍了为什么要把 Prefill 和 Decode 拆开。本文继续往下走,在单节点 GPU 环境中搭建一个可以从头复现的 PD 分离 Demo,先用最小实现把整个链路跑通。

本文不引入复杂组件,只使用 vLLM 和一个轻量 Proxy,把 Prefill 与 Decode 两个阶段串起来。

Demo 主要看两件事:

  • PD 分离后的请求执行流程,观察同一个请求如何依次经过 Proxy、Prefill 和 Decode;
  • PD 分离中的 KV Cache 数据流,确认 Prefill 生成的 KV Cache 如何通过 KV Connector/NIXL 交给 Decode。

TL;DR

请求先由 Proxy 发送到 Prefill 计算 Prompt 和 KV Cache,再携带 kv_transfer_params 请求 Decode;KV Cache 由 Decode 通过 NIXL 直接从 Prefill 拉取,不经过 Proxy。
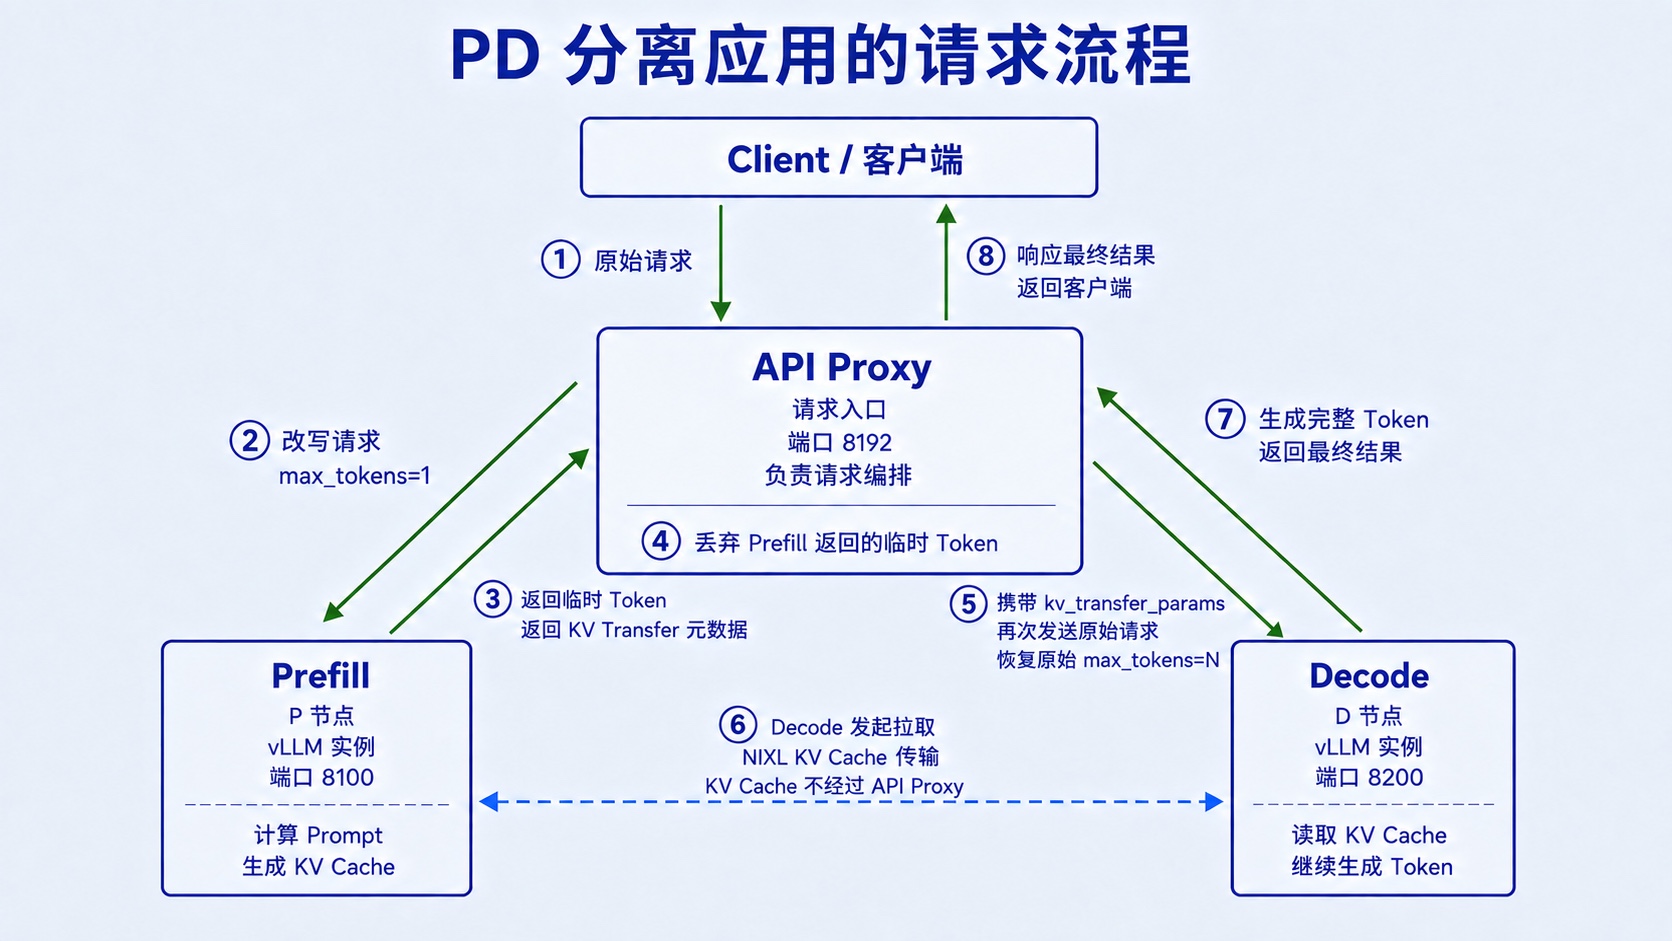
vLLM PD 分离应用的请求流程

1. 环境准备

1.1 准备 GPU 环境

本文不展开 GPU 基础环境的安装过程,大家可以先参考前置文章了解 GPU 环境搭建指南:如何在物理机、Docker、K8s 等环境中使用 GPU

1.2 准备模型

从 ModelScope 下载模型,为了简化直接使用 Qwen2.5-0.5B-Instruct 这个小模型。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
python3 -m pip install --upgrade modelscope

mkdir -p /opt/models/Qwen2.5-0.5B-Instruct

modelscope download \
  --model Qwen/Qwen2.5-0.5B-Instruct \
  --local_dir /opt/models/Qwen2.5-0.5B-Instruct

test -f /opt/models/Qwen2.5-0.5B-Instruct/config.json
test -f /opt/models/Qwen2.5-0.5B-Instruct/model.safetensors
du -sh /opt/models/Qwen2.5-0.5B-Instruct

2. PD 分离

2.1 Connector 选择

Connector 可以理解为 Prefill 和 Decode 之间传递和访问 KV Cache 的具体机制

  • Prefill 是 KV Cache 的生产者,负责生成并保存 KV Cache;
  • Decode 是 KV Cache 的消费者,负责找到并加载这部分 KV Cache,然后继续生成。

vLLM 提供了多种 KV Connector,用于不同场景下的 KV Cache 传输和管理,例如 NixlConnector、LMCacheConnectorV1、MooncakeConnector 等。

不同版本支持的 Connector 及参数可能发生变化,实际使用时应以对应版本的文档和源码为准。

本文选择 NixlConnector

  • Prefill 使用 kv_producer 角色生成 KV Cache
  • Decode 使用 kv_consumer 角色通过 NIXL 拉取 KV Cache。

这样可以在不引入额外缓存服务的前提下,直接观察一次跨 vLLM 实例的 KV Cache 传输过程,并从 Decode 日志中确认传输是否成功。

2.2 用 nerdctl 启动单容器和 P/D 进程

简单起见,我们直接使用 nerdctl 启动一个 GPU 容器提供完整的 vLLM 运行环境,再在容器内启动三个相互独立的进程:Prefill、Decode 和 Proxy。

虽然都在一个容器中运行,但是 Prefill 和 Decode 仍然是两个独立的 vLLM 实例,分别监听不同的 HTTP 端口,拥有各自的 KV Cache 管理和 NIXL Connector,它们只是为了简化 Demo,共享同一个容器的网络命名空间和一张 GPU。

先下载与 vLLM v0.27.1 匹配的 toy Proxy。下载到宿主机的工作目录,随后通过目录挂载让容器读取:

1
2
3
4
5
6
7
mkdir -p /tmp/vllm-pd-demo

# toy_proxy_server.py 源码(v0.27.1):
# https://github.com/vllm-project/vllm/blob/v0.27.1/tests/v1/kv_connector/nixl_integration/toy_proxy_server.py
curl -fL --retry 3 --retry-delay 2 \
  "https://raw.githubusercontent.com/vllm-project/vllm/v0.27.1/tests/v1/kv_connector/nixl_integration/toy_proxy_server.py" \
  -o /tmp/vllm-pd-demo/toy_proxy_server.py

创建并启动一个后台容器,三个服务进程稍后分别通过 nerdctl exec 启动:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
nerdctl run -d \
  --name vllm-pd-demo \
  --gpus all \
  --ipc=host \
  --ulimit memlock=-1 \
  --ulimit stack=67108864 \
  -p 8192:8192 \
  -p 8100:8100 \
  -p 8200:8200 \
  --volume /opt/models/Qwen2.5-0.5B-Instruct:/models:ro \
  --volume /tmp/vllm-pd-demo:/work \
  --entrypoint /bin/bash \
  docker.m.daocloud.io/vllm/vllm-openai:v0.27.1 \
  -lc "sleep infinity"

确认容器可以看到 GPU:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
root@lixd-test-gpu:~# nerdctl exec vllm-pd-demo nvidia-smi
Wed Aug 26 03:14:55 2026
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.173.02             Driver Version: 580.173.02     CUDA Version: 13.0     |
+-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  Tesla T4                       Off |   00000000:00:06.0 Off |                    0 |
| N/A   46C    P0             29W /   70W |    6847MiB /  15360MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+

+-----------------------------------------------------------------------------------------+
| Processes:                                                                              |
|  GPU   GI   CI              PID   Type   Process name                        GPU Memory |
|        ID   ID                                                               Usage      |
|=========================================================================================|
|  No running processes found                                                             |
+-----------------------------------------------------------------------------------------+

接下来打开三个终端。每个终端先执行下面的命令进入同一个容器:

1
nerdctl exec -it vllm-pd-demo bash

终端一:启动 Prefill

在第一个容器终端中执行:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
export VLLM_NIXL_SIDE_CHANNEL_HOST=127.0.0.1
export UCX_NET_DEVICES=all
export UCX_TLS=tcp,cuda_copy,cuda_ipc

VLLM_NIXL_SIDE_CHANNEL_PORT=5600 vllm serve /models \
  --served-model-name=qwen-pd-demo \
  --host=0.0.0.0 \
  --port=8100 \
  --max-model-len=1024 \
  --max-num-seqs=4 \
  --gpu-memory-utilization=0.30 \
  --enforce-eager \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_producer","kv_load_failure_policy":"fail"}' \
  2>&1 | tee /work/prefill.log

终端二:启动 Decode

在第二个容器终端中执行:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
export VLLM_NIXL_SIDE_CHANNEL_HOST=127.0.0.1
export UCX_NET_DEVICES=all
export UCX_TLS=tcp,cuda_copy,cuda_ipc

VLLM_NIXL_SIDE_CHANNEL_PORT=5601 vllm serve /models \
  --served-model-name=qwen-pd-demo \
  --host=0.0.0.0 \
  --port=8200 \
  --max-model-len=1024 \
  --max-num-seqs=4 \
  --gpu-memory-utilization=0.30 \
  --enforce-eager \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_consumer","kv_load_failure_policy":"fail"}' \
  2>&1 | tee /work/decode.log

这里 Prefill 和 Decode 使用不同的 NIXL side channel 端口 56005601,避免两个进程在同一个容器的网络命名空间中发生端口冲突。

VLLM_NIXL_SIDE_CHANNEL_HOST 使用 127.0.0.1,是因为两个 vLLM 实例位于同一个容器内。

这两个命令会以前台进程运行,日志会直接显示在各自终端;命令末尾的 tee 还会把日志分别保存到 /work/prefill.log/work/decode.log

2.3 启动 Proxy 进程

普通的 OpenAI-compatible Proxy 只负责转发请求,不会自动完成 PD 分离。这里使用 vLLM v0.27.1 仓库中与该版本匹配的 toy_proxy_server.py:它会先请求 Prefill,再把 Prefill 返回的 kv_transfer_params 交给 Decode。

在第三个容器终端中执行:

1
2
3
4
5
6
7
8
python3 /work/toy_proxy_server.py \
  --host=0.0.0.0 \
  --port=8192 \
  --prefiller-hosts=127.0.0.1 \
  --prefiller-ports=8100 \
  --decoder-hosts=127.0.0.1 \
  --decoder-ports=8200 \
  2>&1 | tee /work/proxy.log

Proxy 通过 127.0.0.1:8100127.0.0.1:8200 访问同一容器内的 Prefill、Decode,客户端则通过宿主机发布的 8192 端口访问 Proxy。

2.4 验证

Proxy 启动后,可以先通过 /healthcheck 确认 Proxy 已正常启动,并识别到配置的 Prefill 和 Decode 实例:

1
2
root@lixd-test-gpu:~# curl -fsS http://127.0.0.1:8192/healthcheck
{"status":"ok","prefill_instances":1,"decode_instances":1}

确认 Prefill 和 Decode 都完成模型加载后,再发送完整请求。

1
2
curl -fsS http://127.0.0.1:8100/health
curl -fsS http://127.0.0.1:8200/health

发送一次完整请求

不要分别手工请求 Prefill 和 Decode,也不要手工复制 kv_transfer_params。Proxy 会自动完成这几步:

  1. 把请求改写成 max_tokens=1,并发送给 Prefill;
  2. 读取 Prefill 返回的 KV Transfer 元数据;
  3. 恢复客户端原始生成参数,把请求发送给 Decode;
  4. 将 Decode 的结果返回给客户端。

从宿主机通过发布的 Proxy 端口发送请求:

1
2
3
4
5
6
7
8
9
curl -sS --max-time 180 http://127.0.0.1:8192/v1/completions \
  -H "Content-Type: application/json" \
  --data-binary '{
    "model": "qwen-pd-demo",
    "prompt": "Explain the request flow between Prefill and Decode in PD disaggregation.",
    "max_tokens": 8,
    "temperature": 0,
    "stream": false
  }'

成功时会返回 HTTP 200 和一个 completion 响应,通常包含:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
{
  "id": "cmpl-...",
  "model": "qwen-pd-demo",
  "choices": [
    {
      "finish_reason": "length"
    }
  ],
  "usage": {
    "prompt_tokens": 15,
    "completion_tokens": 8
  },
  "kv_transfer_params": null
}

最终响应中的 kv_transfer_paramsnull 是正常的,因为它是 Decode 生成并返回给客户端的最终响应。KV Transfer 元数据只在 Proxy 内部从 Prefill 传给 Decode。

检查日志确认 PD 分离

HTTP 200 只能证明接口返回成功,还需要结合 Decode 日志确认 KV Cache 传输。按照本文命令启动时,三个服务的日志既会显示在终端,也会写入 /work。在第四个终端中执行:

1
2
3
nerdctl exec vllm-pd-demo \
  grep -E "NIXL compatibility check passed|KV Transfer metrics|POST /v1/completions" \
  /work/prefill.log /work/decode.log /work/proxy.log

Decode 至少应该出现类似日志:

1
2
3
4
5
NIXL compatibility check passed
KV Transfer metrics: Num successful transfers=1
Avg xfer time (ms)=...
Avg MB per transfer=...
Throughput (MB/s)=...

其中 Decode 的 Num successful transfers=1 是判断 KV Cache 确实被拉取的关键证据。Prefill 和 Decode 的请求日志应该都返回 200 OK,Proxy 日志应该出现 POST /v1/completions ... 200 OKNIXL compatibility check passed 只能说明两端配置兼容,不能单独证明本次请求已经完成 KV Cache 传输。

一次已验证的运行记录

下面是完成一次推理请求后,从三个日志文件中筛选出的关键日志。查询命令的输出包含多次请求记录,下面保留与这次验证相关的关键行:

1
2
3
4
5
/work/prefill.log:(APIServer pid=40) INFO:     127.0.0.1:45150 - "POST /v1/completions HTTP/1.1" 200 OK
/work/decode.log:(EngineCore pid=198) INFO 08-25 07:35:17 [base_worker.py:680] NIXL compatibility check passed (hash: b5f080ccb62b60a662e683a3e38305f1609bc636242f37736e2a8bba912cba59)
/work/decode.log:(APIServer pid=52) INFO 08-25 07:50:17 [metrics.py:103] KV Transfer metrics: Num successful transfers=1, Avg xfer time (ms)=1.51, P90 xfer time (ms)=1.51, Avg post time (ms)=1.51, P90 post time (ms)=1.51, Avg MB per transfer=0.188, Throughput (MB/s)=124.172, Avg number of descriptors=24.0
/work/decode.log:(APIServer pid=52) INFO:     127.0.0.1:58494 - "POST /v1/completions HTTP/1.1" 200 OK
/work/proxy.log:INFO:     10.4.0.1:57586 - "POST /v1/completions HTTP/1.1" 200 OK

其中 KV Transfer metricsNum successful transfers=1 是本次验证最关键的证据,表示 Decode 侧至少完成了一次 NIXL KV Cache 传输。Avg MB per transfer=0.188 表示本次平均传输了约 0.188 MB 的 KV Cache。Prefill、Decode 和 Proxy 的请求都返回了 200 OK,说明请求链路也完整走通。

清理

停止并删除 Demo 容器:

1
nerdctl rm -f vllm-pd-demo

3. PD 分离的请求执行流程

前面的验证确认了请求确实经过了 Prefill、Decode。下面把一次请求拆开,分别看控制请求和 KV Cache 数据是如何流动的。

一次请求的执行流程如下:

vLLM PD 分离应用的请求流程

3.1 Client -> Proxy:请求进入编排层

客户端只需要发送一次普通的 OpenAI-compatible Completion 请求,例如设置 max_tokens=1024。客户端不需要知道 Prefill、Decode 的地址,也不需要自己构造 kv_transfer_params

Proxy 为请求生成 request ID,同时保留客户端原始生成参数。发送给 Prefill 的请求会基于原始请求进行改写,后续再使用原始参数构造 Decode 请求。

3.2 Proxy -> Prefill:只做 Prefill

Proxy 将请求发送给 Prefill 时,会把 max_tokens 改为 1,同时附加类似下面的 kv_transfer_params

1
2
3
4
5
6
{
  "kv_transfer_params": {
    "do_remote_decode": true,
    "do_remote_prefill": false
  }
}

这表示当前实例负责 Prefill,后续 Decode 由远端实例完成。Prefill 处理完整 Prompt,生成对应的 KV Cache。由于请求被设置为 max_tokens=1,Prefill 还会产生一个单 Token 响应,同时返回 KV Transfer 元数据。

这个 Token 后续会被 Proxy 丢弃。

这些元数据包含 Prefill 侧的 Engine ID、请求 ID、KV block ID,以及 NIXL side channel 的地址和端口等信息,它们是下一阶段 Decode 找到 KV Cache 的定位信息。在本文单容器 Demo 中,实例地址使用 127.0.0.1;实际多容器或多节点部署时,应替换成 Decode 可以访问的地址。

3.3 Prefill -> Proxy -> Decode:交接 KV Cache

Proxy 会把 Prefill 返回的第一个 Token 直接丢弃,然后取出其中的 kv_transfer_params,覆盖到原始请求上,并恢复客户端要求的 max_tokens

发送给 Decode 的请求大致包含:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
{
  "max_tokens": 8,
  "kv_transfer_params": {
    "do_remote_prefill": true,
    "do_remote_decode": false,
    "remote_engine_id": "...",
    "remote_request_id": "...",
    "remote_block_ids": [[1]],
    "remote_host": "127.0.0.1",
    "remote_port": "<NIXL side-channel port>"
  }
}

这里有两条不同的链路:

  • 控制请求通过 Proxy 的 HTTP 端口到达 Prefill 和 Decode;
  • KV Cache 不经过 Proxy,Decode 根据元数据通过 NIXL 直接从 Prefill 读取。

因此,Proxy 负责请求编排,Connector/NIXL 负责 KV Cache 传输,两者是不同的职责。单容器只让 HTTP 地址和 NIXL 地址都表现为回环地址,并没有把两个 vLLM 实例合并成一个 Engine。

3.4 Decode -> Proxy -> Client:继续生成并返回结果

Decode 收到请求后,根据 remote_engine_idremote_request_idremote_block_ids 等信息,通过 NIXL 拉取 Prefill 生成的 KV Cache。KV Cache 加载完成后,Decode 不再重复计算完整 Prompt,而是从已有上下文继续逐 Token 生成。

最终返回给客户端的是 Decode 的响应,Prefill 的临时 Token 不会出现在最终结果中。Decode 日志中的 NIXL compatibility check passedNum successful transfers=1,分别说明传输能力协商成功,以及这次请求确实完成了 KV Cache 传输。

4. PD 分离在生产环境中的挑战

前面的 Demo 有意把环境压到了最小:只有一个 Prefill、一个 Decode,而且两个实例还运行在同一个容器和同一张 GPU 上。这样很适合观察请求和 KV Cache 的流向,但真正到了多实例、跨节点环境后,很多问题才会出现。

在真正的生产环境中,PD 分离还需要解决很多更复杂的问题,例如:

  • KV Cache 管理:不仅要解决 KV Cache 如何从 Prefill 传输到 Decode,还要考虑缓存的生命周期、释放与回收、传输超时与失败重试,以及跨节点场景下的网络带宽和传输开销。
  • P/D 实例调度:生产环境通常会同时运行多个 Prefill 和 Decode 实例。Router 需要根据实例负载、KV Cache/Prefix Cache 命中情况等信息选择合适的 P、D 实例,而不是简单地做一次请求转发。
  • P/D 容量配比与扩缩容:Prefill 和 Decode 的资源特征不同,Prompt 长度、输出长度以及请求并发度变化后,两侧的压力也会发生变化,因此需要分别进行容量规划、负载均衡和弹性扩缩容。
  • 故障处理:Prefill 成功但 Decode 失败、KV Cache 传输异常、请求超时或取消等情况,都需要处理请求重试、状态清理以及 KV Cache 回收等问题。
  • 性能与可观测性:PD 分离并不会凭空提高吞吐。它主要解决的是 Prefill 和 Decode 相互干扰的问题,让 TTFT 和 ITL 可以分别优化,特别是改善 tail ITL。代价也很直接:多了一层请求调度和 KV Cache 传输。生产环境还需要持续关注 P/D 排队时间、KV Cache 传输耗时、传输带宽和失败情况,判断拆分带来的收益是否真正大于额外成本。

这篇文章先把 PD 分离最基础的链路跑通。到了多实例、跨节点环境后,关注点就会从“KV Cache 能不能传过去”,转向实例怎么调度、缓存怎么管理、失败怎么处理,以及拆分之后到底能不能改善实际的延迟指标。

5. 小结

本文通过一个基于 vLLM、NixlConnector 和 toy Proxy 的最小 Demo,把 PD 分离之后的请求执行流程和 KV Cache 数据流串了起来。

PD 分离之后,请求流程如下:

  1. Client 将原始请求发送给 API Proxy。
  2. API Proxy 将请求改写为 max_tokens=1,并发送给 Prefill 实例。
  3. Prefill 计算完整 Prompt,生成 KV Cache,同时返回一个临时 Token 和 KV Transfer 元数据。
  4. API Proxy 丢弃 Prefill 返回的临时 Token,只保留 KV Transfer 元数据。
  5. API Proxy 将原始请求再次发送给 Decode,并携带 kv_transfer_params,恢复原始的 max_tokens=N
  6. Decode 根据传输元数据,通过 NIXL 直接从 Prefill 拉取 KV Cache,这部分数据不经过 API Proxy。
  7. Decode 基于已经加载的 KV Cache 继续生成完整 Token,并将最终结果返回给 API Proxy。
  8. API Proxy 将 Decode 的最终结果返回给 Client。

其中,API Proxy 负责请求编排,Prefill 负责 Prompt 计算和 KV Cache 生成,Decode 负责拉取 KV Cache 并继续生成。一个容器降低了环境准备和网络配置的复杂度,但 Prefill、Decode 仍然是两个独立的 vLLM 实例,NixlConnector 仍然负责两者之间的 KV Cache 传输。

0%