Home avatar

李学端(意琦行) | AI Infra / Kubernetes / GPU Scheduling

专注 Kubernetes、GPU 资源管理与调度,以及云原生 AI Infra

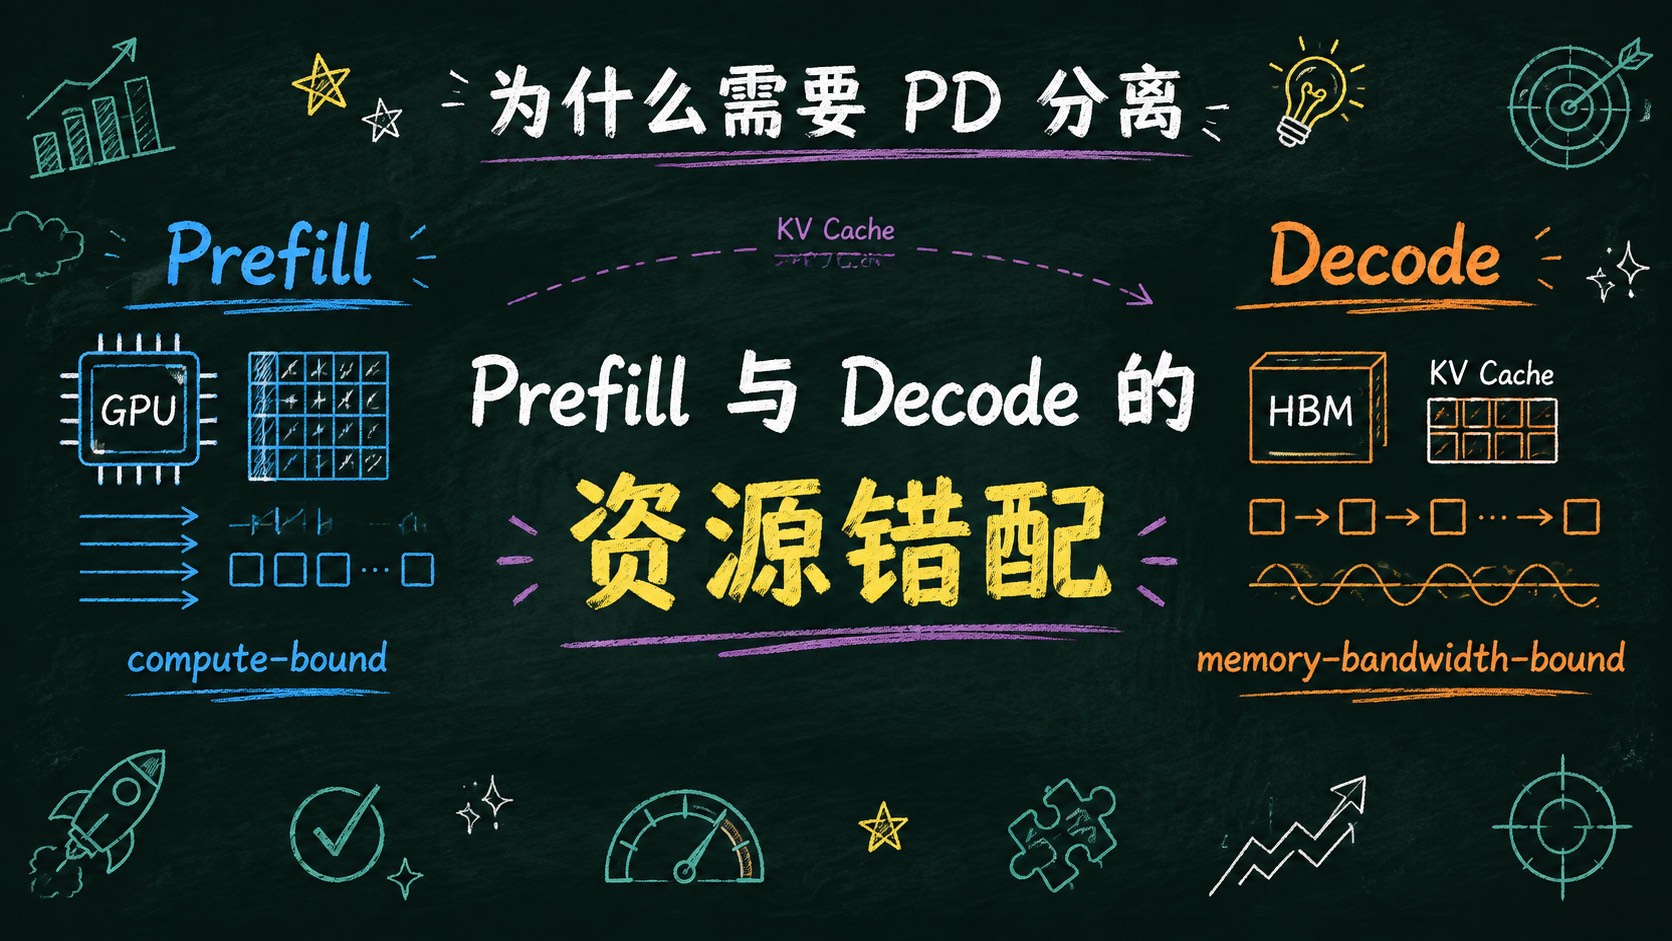
VLLM PD 分离实战:从请求流程理解 Prefill、Decode 与 KV Cache 传输
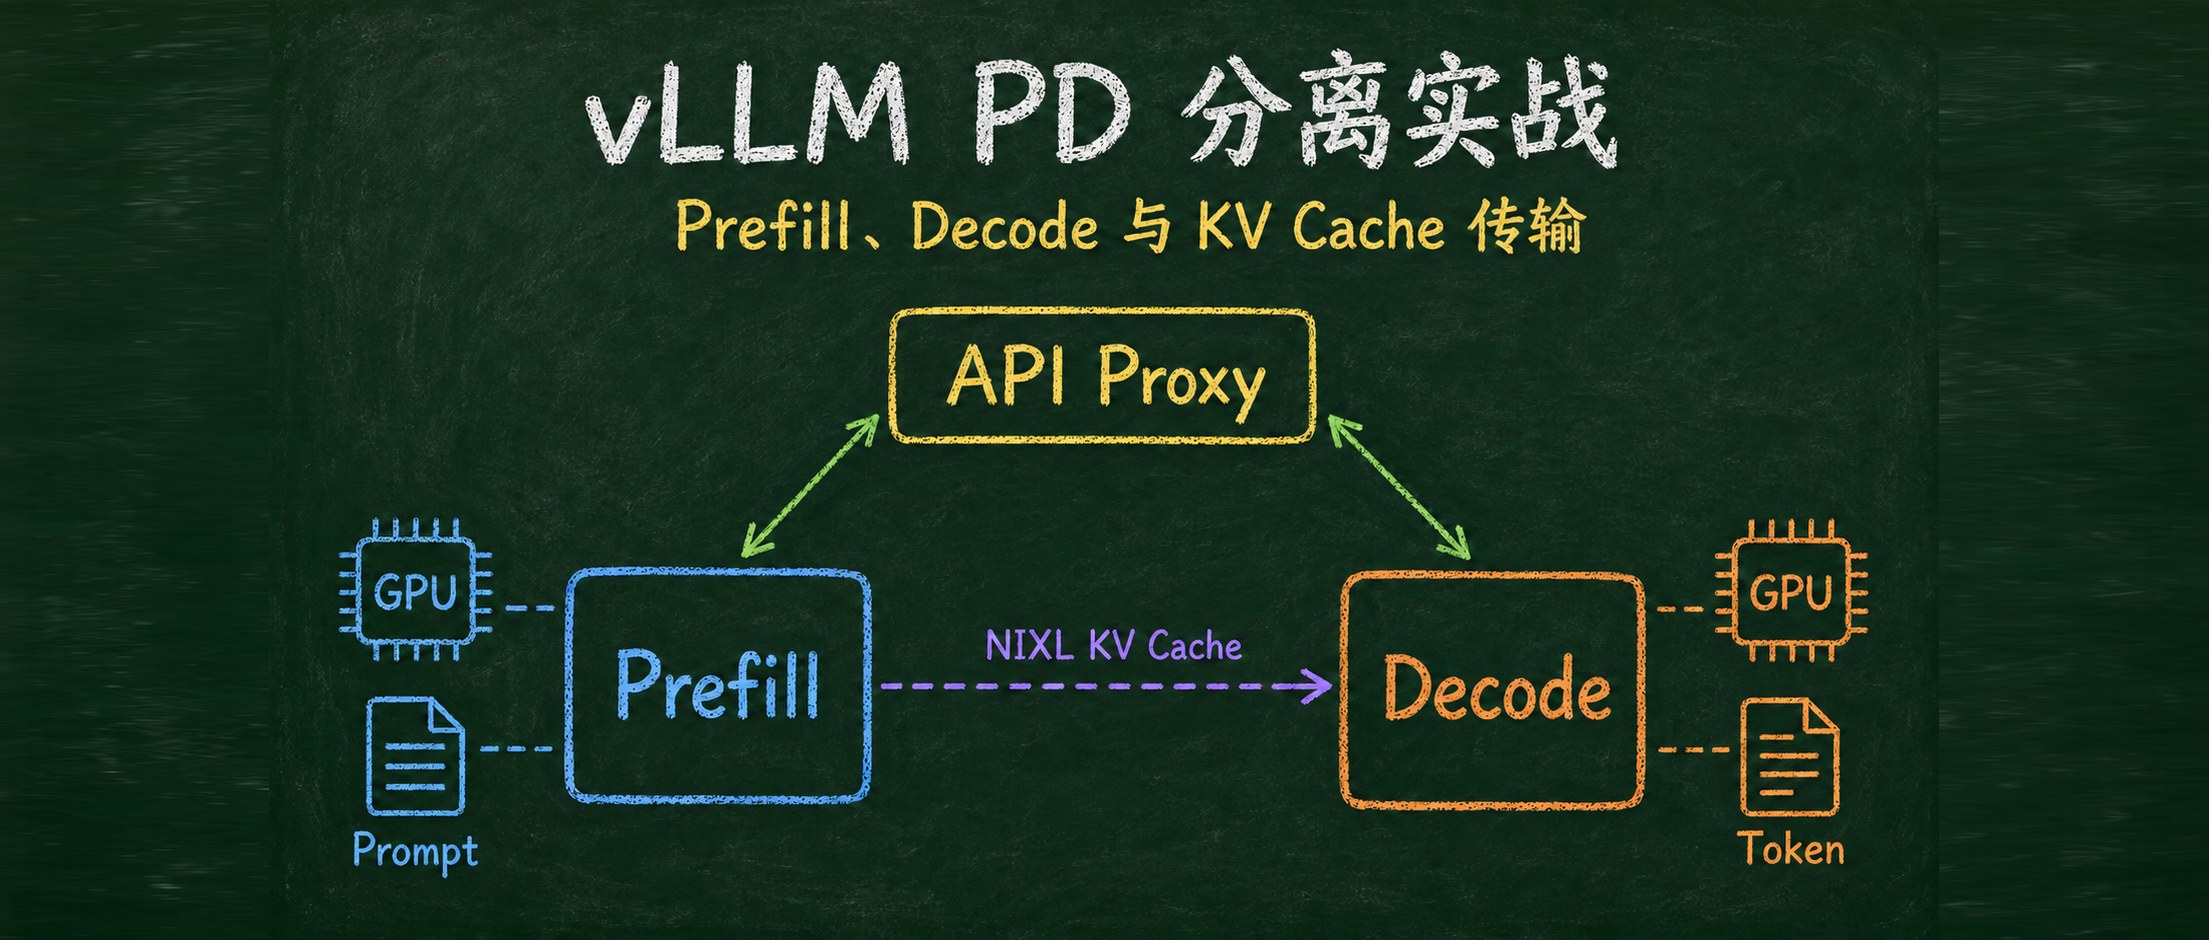
vLLM PD 分离实战:Prefill、Decode 与 KV Cache 传输

上一篇 https://www.lixueduan.com/posts/ai/27-why-pd-disaggregation/ 介绍了为什么要把 Prefill 和 Decode 拆开。本文继续往下走,在单节点 GPU 环境中搭建一个可以从头复现的 PD 分离 Demo,先用最小实现把整个链路跑通。

本文不引入复杂组件,只使用 vLLM 和一个轻量 Proxy,把 Prefill 与 Decode 两个阶段串起来。

Demo 主要看两件事:

  • PD 分离后的请求执行流程,观察同一个请求如何依次经过 Proxy、Prefill 和 Decode;
  • PD 分离中的 KV Cache 数据流,确认 Prefill 生成的 KV Cache 如何通过 KV Connector/NIXL 交给 Decode。
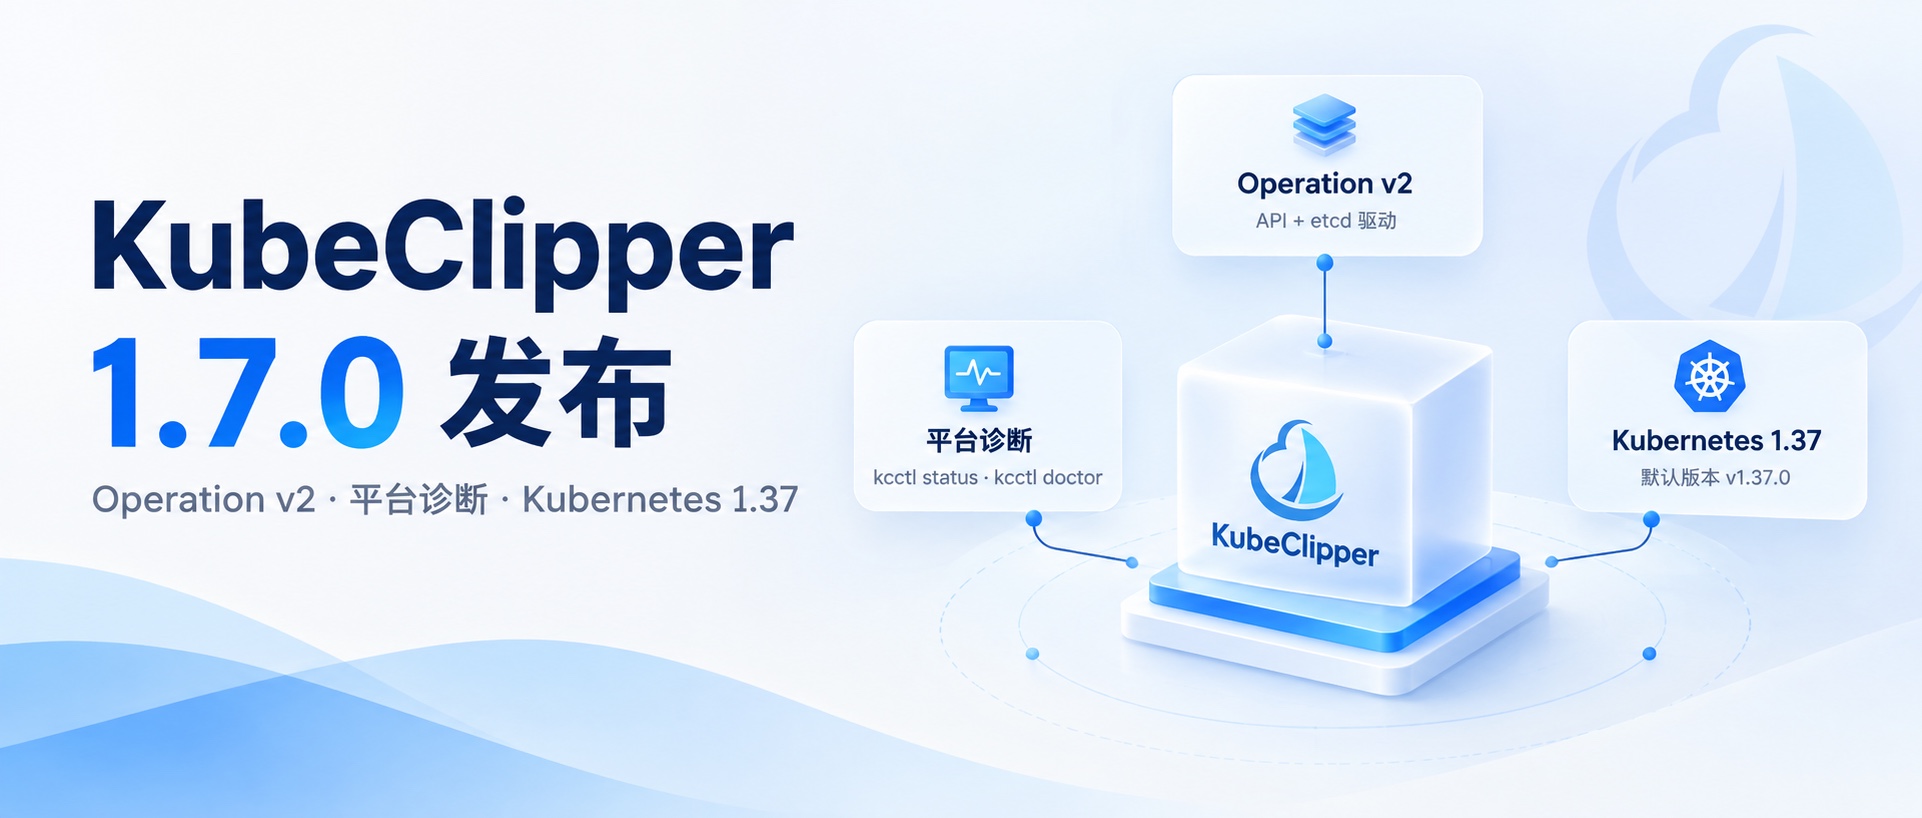
KubeClipper 1.7.0 发布:Operation 优化与 Kubernetes 1.37 支持

kubeclipper-release-1.7.0.jpg

KubeClipper 1.7.0 发布了。

本次版本新增 API 驱动的 Operation v2,移除了旧的 NATS Operation 投递链路,集群创建、扩容、删除等操作统一使用新的 Operation v2。新增 kcctl statuskcctl doctor 平台诊断命令,新增了对 Kubernetes 1.37 版本的支持,并对镜像仓库管理、离线镜像加载和部署预检查进行了优化。

PD 分离详解:Prefill 与 Decode 的瓶颈、拆分与代价

为什么要 PD 分离

LLM 推理服务的性能瓶颈,不只在模型大小和 GPU 算力。副本增加后,请求落到哪个实例、长 Prompt 是否干扰流式输出、KV Cache 能否复用,都会直接影响延迟、吞吐和成本。

其中,Prefill/Decode 分离(PD 分离)是把两类截然不同的计算负载拆到独立资源池中的方案。本文从问题出发,说明它解决什么、代价是什么,以及何时不该使用它。

GPT-5.6 之后,Superpowers 可以卸载了

GPT-5.6 之后,Superpowers 可以卸载了

之前我写过一篇文章 OpenSpec + Superpowers,SDD+TDD 双驱动 AI 编程工作流,记录了我当时把 OpenSpecSuperpowers 组合成一套工作流的尝试。

那时候我觉得这两个东西搭在一起还挺顺,OpenSpec 负责需求和 Spec 对齐,Superpowers 负责计划、TDD、子 Agent 实现和代码审查。

后来,我发现社区里很多人也在用这套工作流,先写需求和设计,拆任务,再实现和验证,大家都在试图给 Agent 加一套更稳定的工作方法。

0%