Kubelet 占用 7.5 GiB 内存:Kubernetes 1.36 Context 泄漏排查
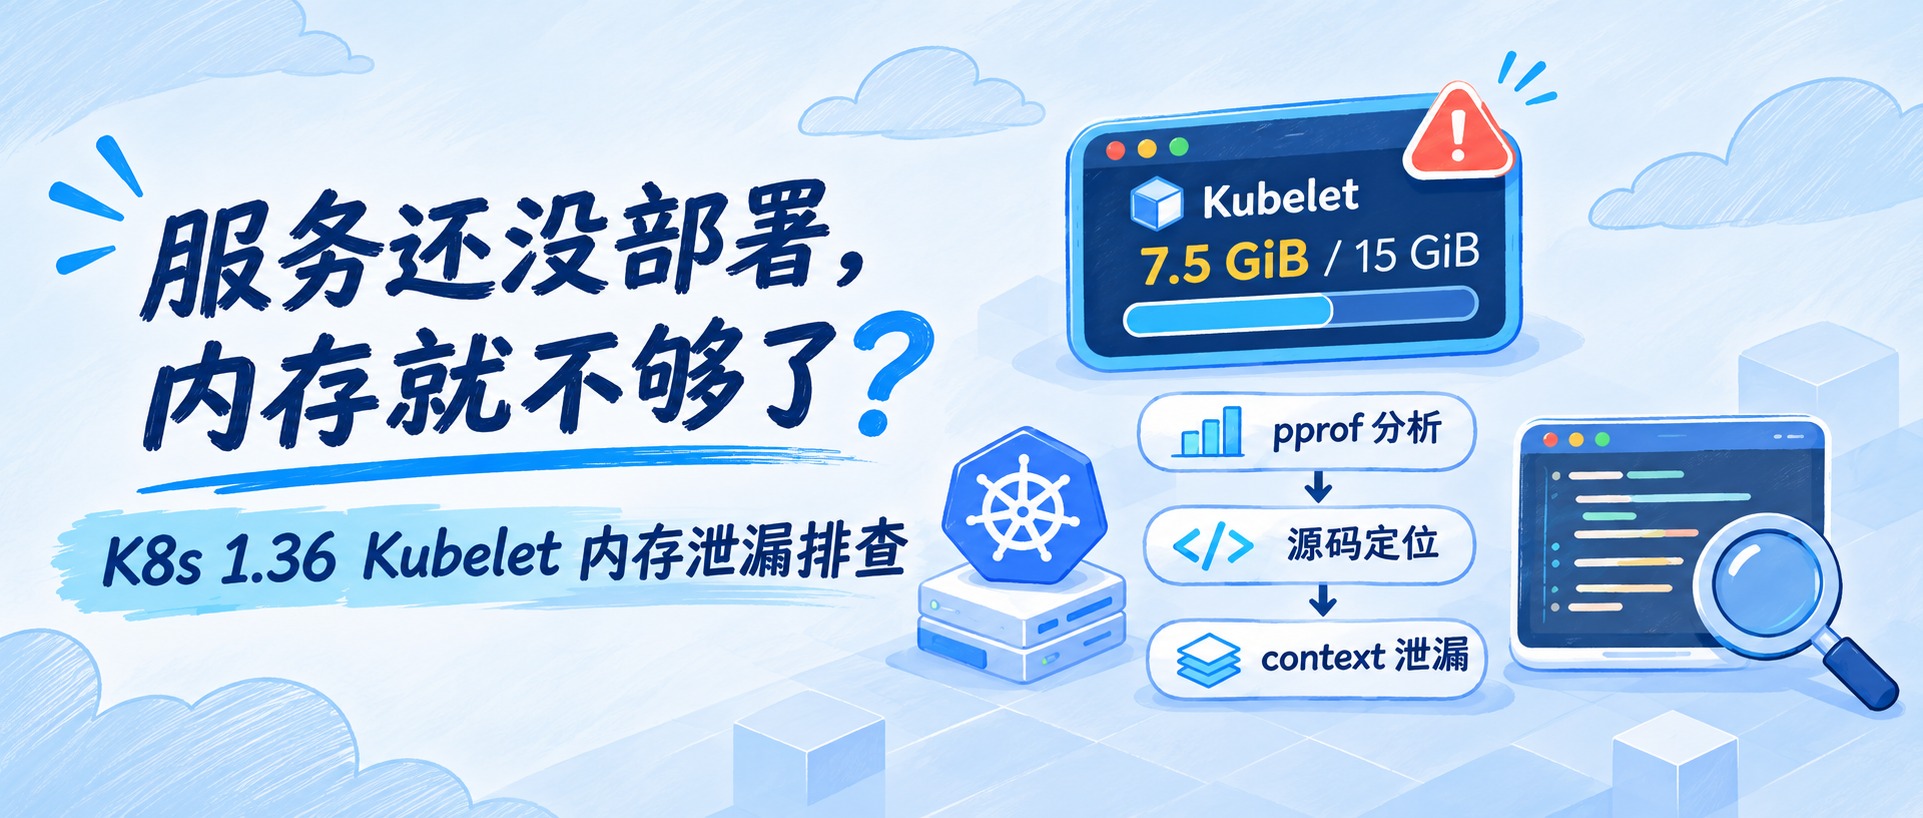
最近在测试环境部署服务时,发现一台主机的可用内存仅剩几百 MiB。清理之前的旧服务后,内存占用依然偏高。
使用 ps 命令看了一下进程,发现 kubelet 占用了约 7.5 GiB 内存。这台机器总共也只有约 15 GiB 内存,kubelet 一个进程就用掉了约一半。
本文主要记录这次排查过程,以及对应的 kubelet 源码和上游修复逻辑。
专注 Kubernetes、GPU 资源管理与调度,以及云原生 AI Infra专注 Kubernetes、GPU 资源管理与调度,以及云原生 AI Infra
公众号 · 探索云原生
最近在测试环境部署服务时,发现一台主机的可用内存仅剩几百 MiB。清理之前的旧服务后,内存占用依然偏高。
使用 ps 命令看了一下进程,发现 kubelet 占用了约 7.5 GiB 内存。这台机器总共也只有约 15 GiB 内存,kubelet 一个进程就用掉了约一半。
本文主要记录这次排查过程,以及对应的 kubelet 源码和上游修复逻辑。
上一篇 PD 分离详解:Prefill 与 Decode 的瓶颈、拆分与代价 介绍了为什么要把 Prefill 和 Decode 拆开, vLLM PD 分离实战:从请求流程理解 Prefill、Decode 与 KV Cache 传输 则用一个 P、一个 D 和轻量 Proxy,跑通了请求编排与 KV Cache 传输。
完成 Prefill 和 Decode 解耦之后,可以根据场景单独扩缩容 P、D 实例。
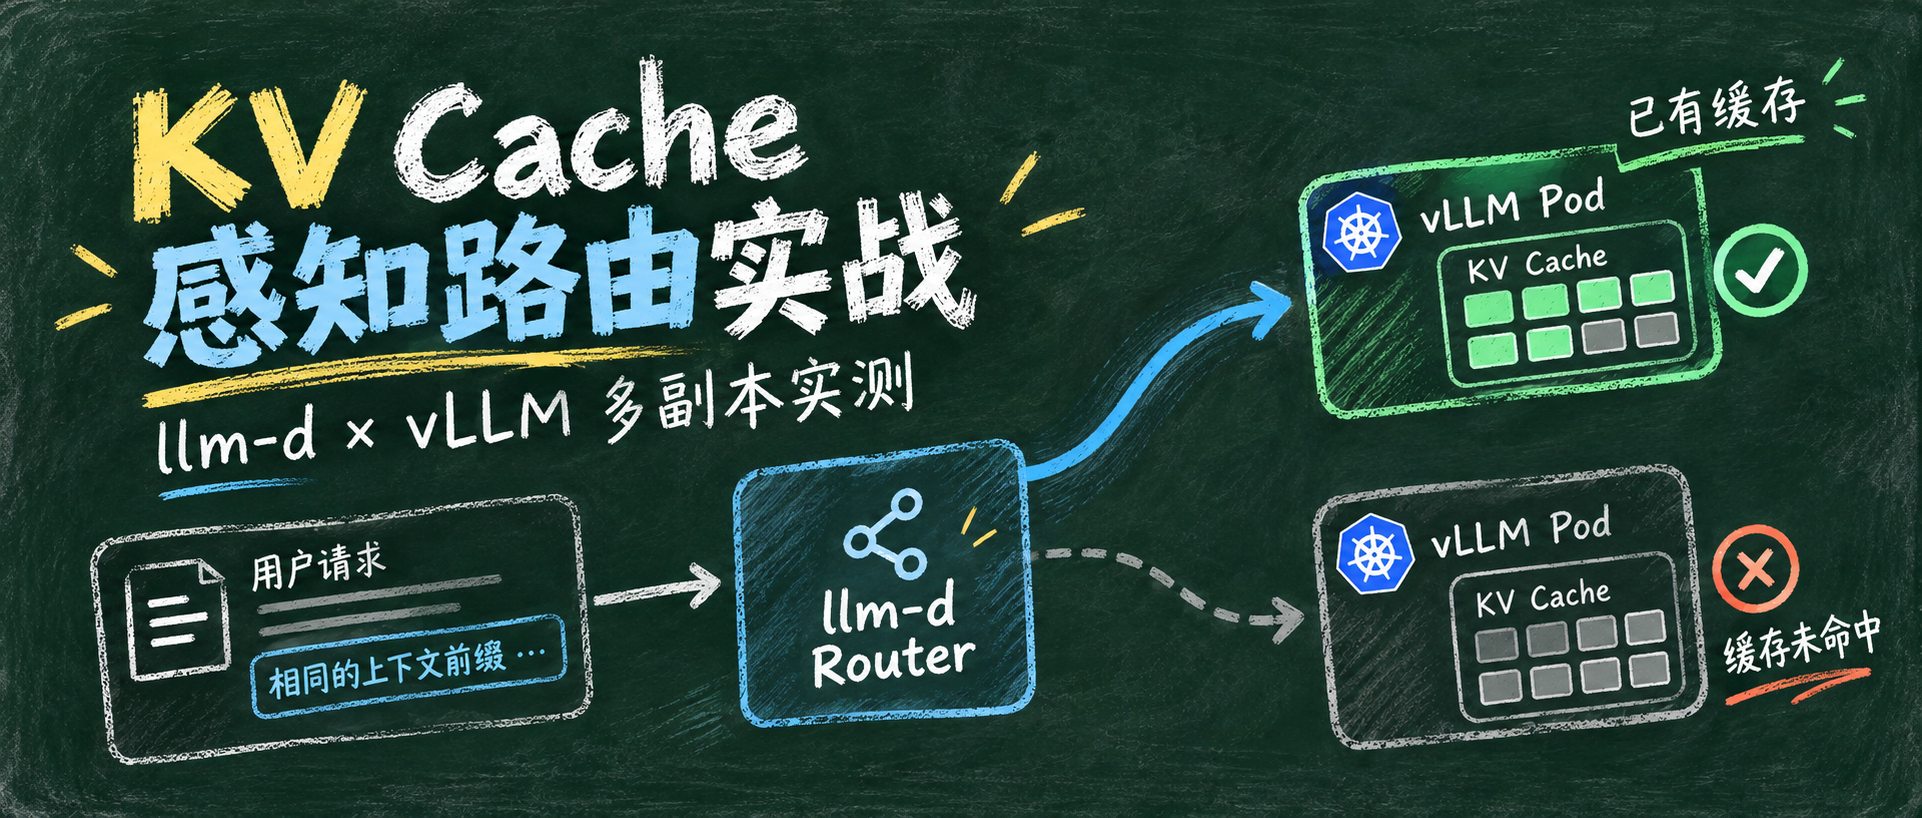
不过多副本推理还需要考虑缓存局部性:当多个实例都开启了前缀缓存,每次请求应该交给谁,才能复用已经计算过的 KV Cache?
本文便基于这个缓存局部性问题展开,通过 llm-d Router 对比随机路由与前缀感知路由。
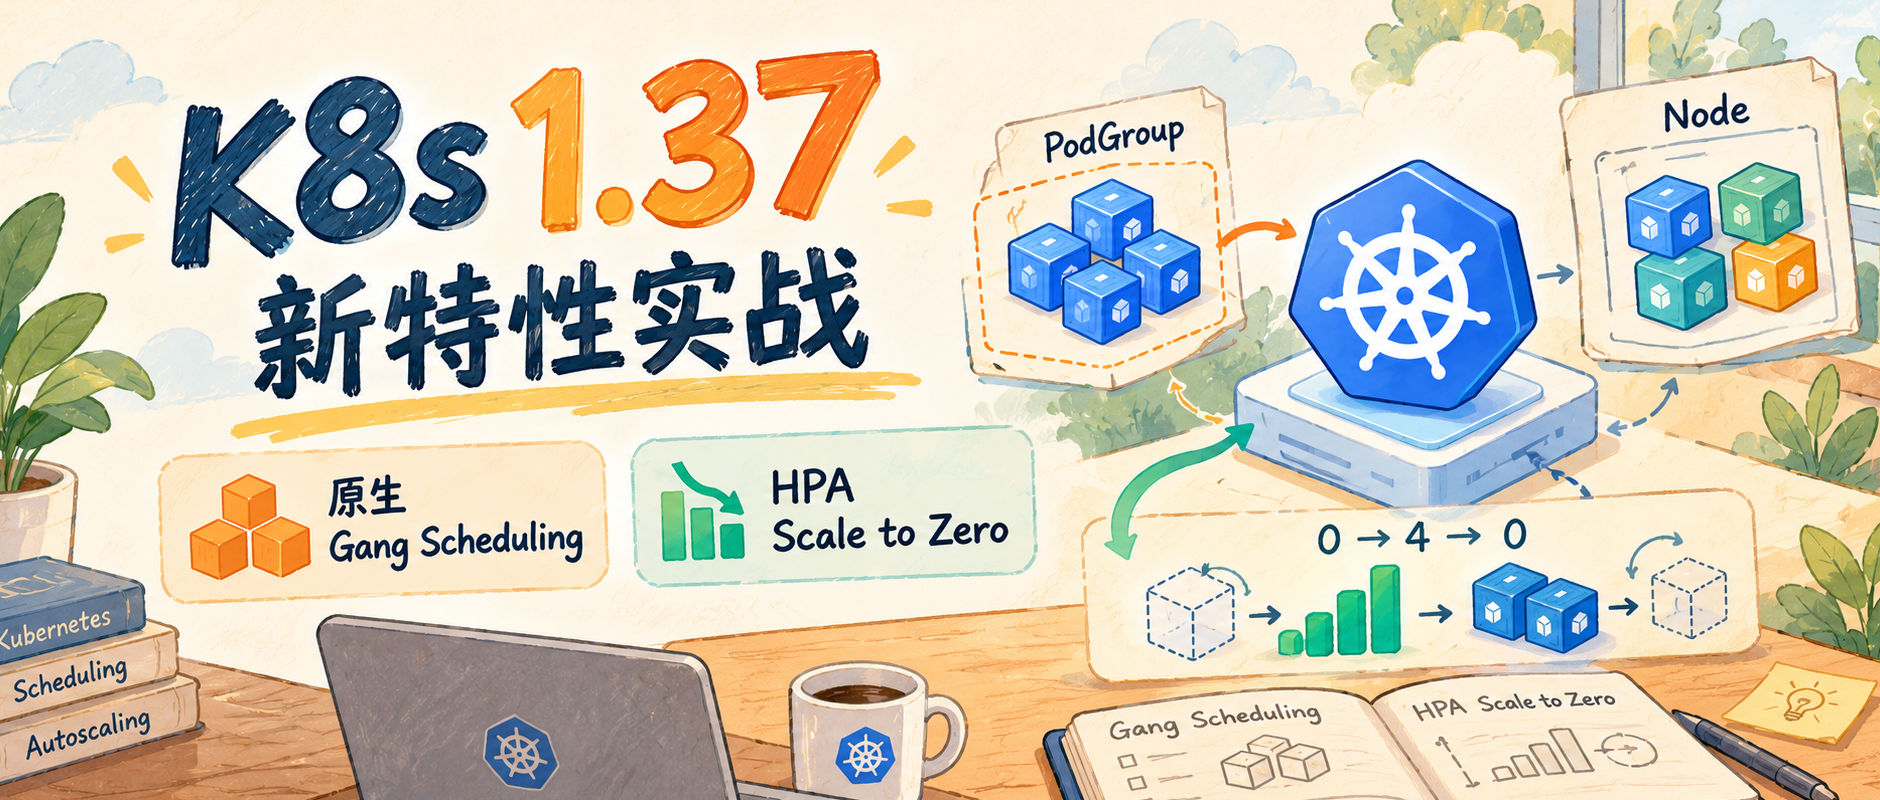
Kubernetes 1.37 已于 2026 年 8 月 26 日发布,今天分享其中两项值得关注的新特性。 原生 Gang Scheduling 和 HPA Scale to Zero 都进入 Beta 了。前者让调度器能够按一组 Pod 来判断资源是否够用,后者让空闲的 Pod 自动缩到零,新任务来了再启动。
这篇主要分享这两个特性,顺便搭一个集群实际跑一下,看看用起来是什么效果。
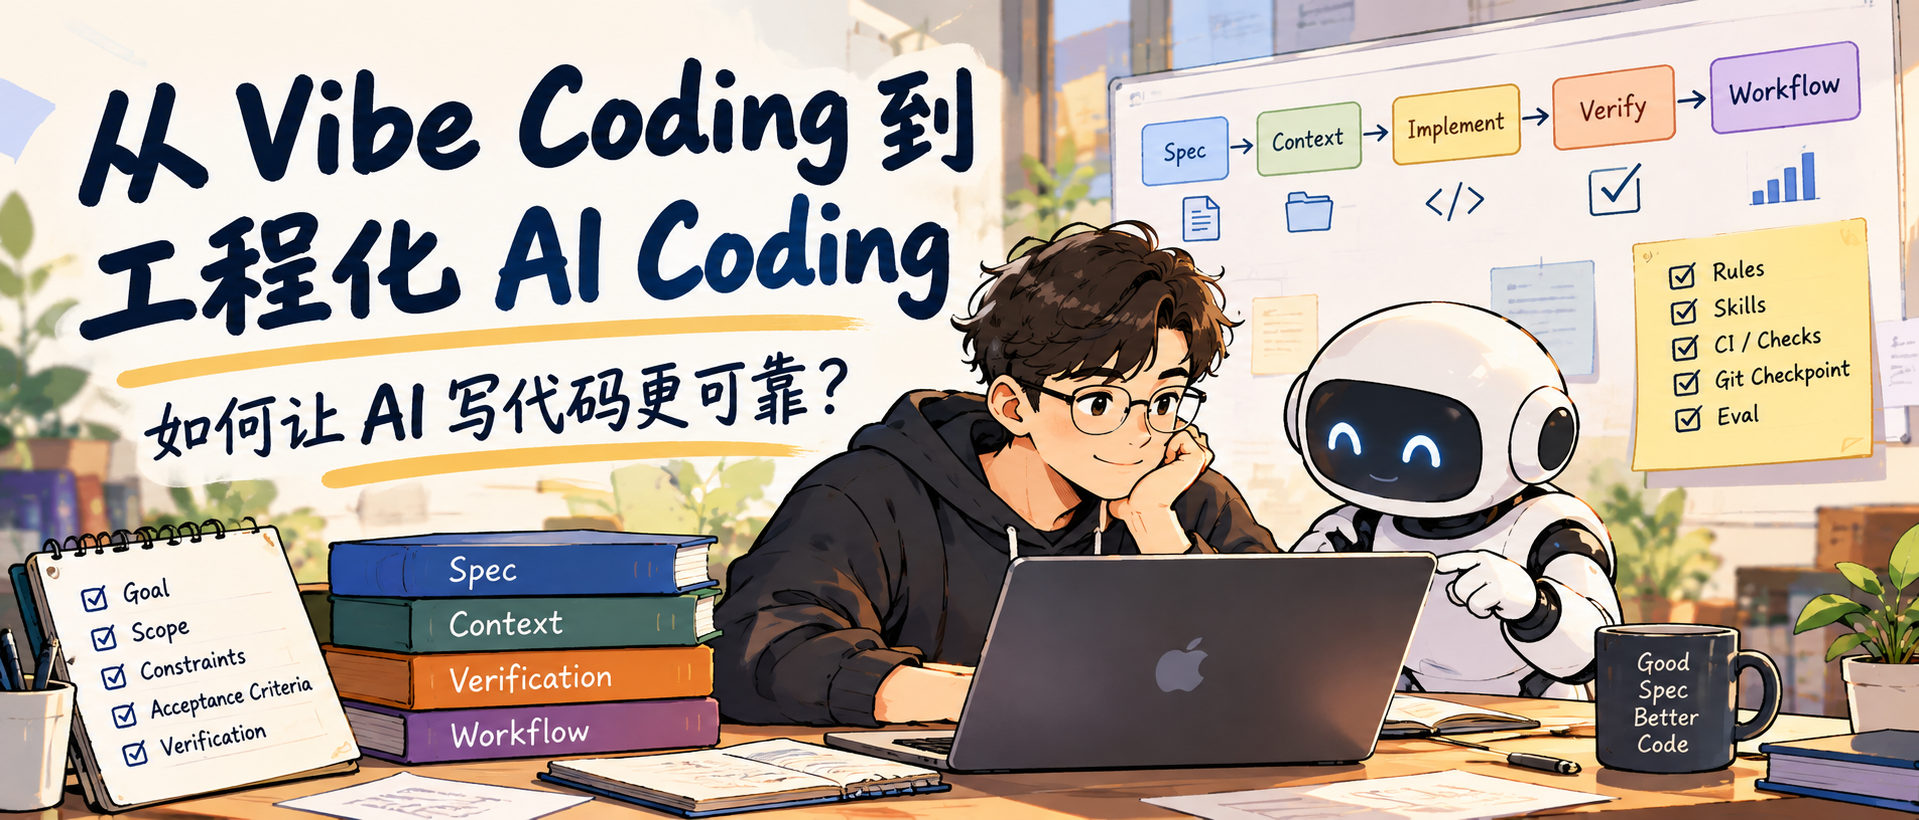
让 Agent 修一个 Bug,它可能很快就给出修改,还附上一句“测试通过”。接下来要做的事情却不少:看它改了哪些文件,核对运行过的测试,确认原来的行为有没有受到影响。
如果任务做到一半需要换一个 Session,还得留下当前进度。代码可以从 Git 里找到,但方案为什么这样定、哪个问题还没解决,需要另外记录。
这篇文章就从这些环节展开,讨论需求怎么写、代码该让 Agent 看哪些,以及改完以后怎么验收。
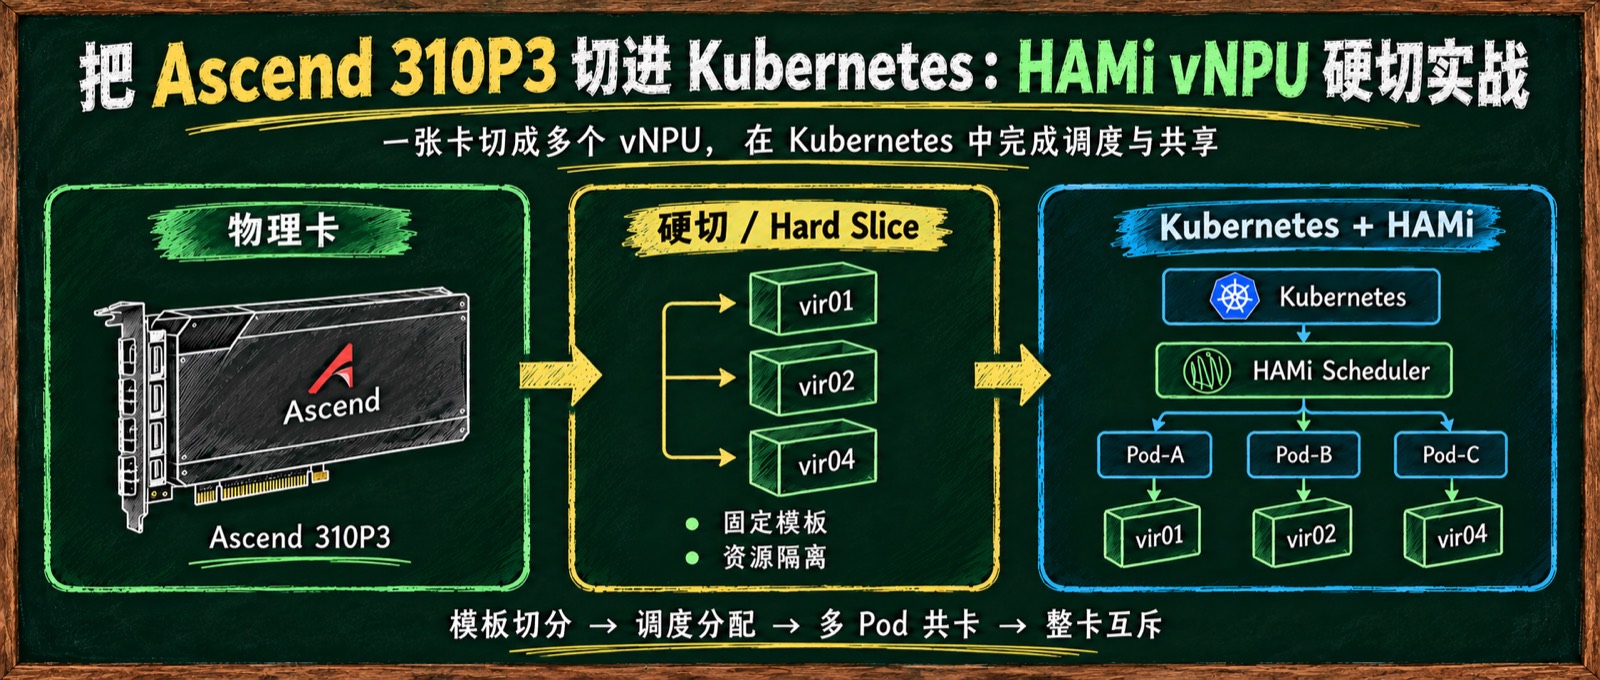
前一篇《Ascend vNPU 实战:从原生 Docker 到 Ascend Docker Runtime》已经跑通了 vNPU 的两种用法,本文继续把这套能力接进 Kubernetes,用 HAMi 统一管理 vNPU。
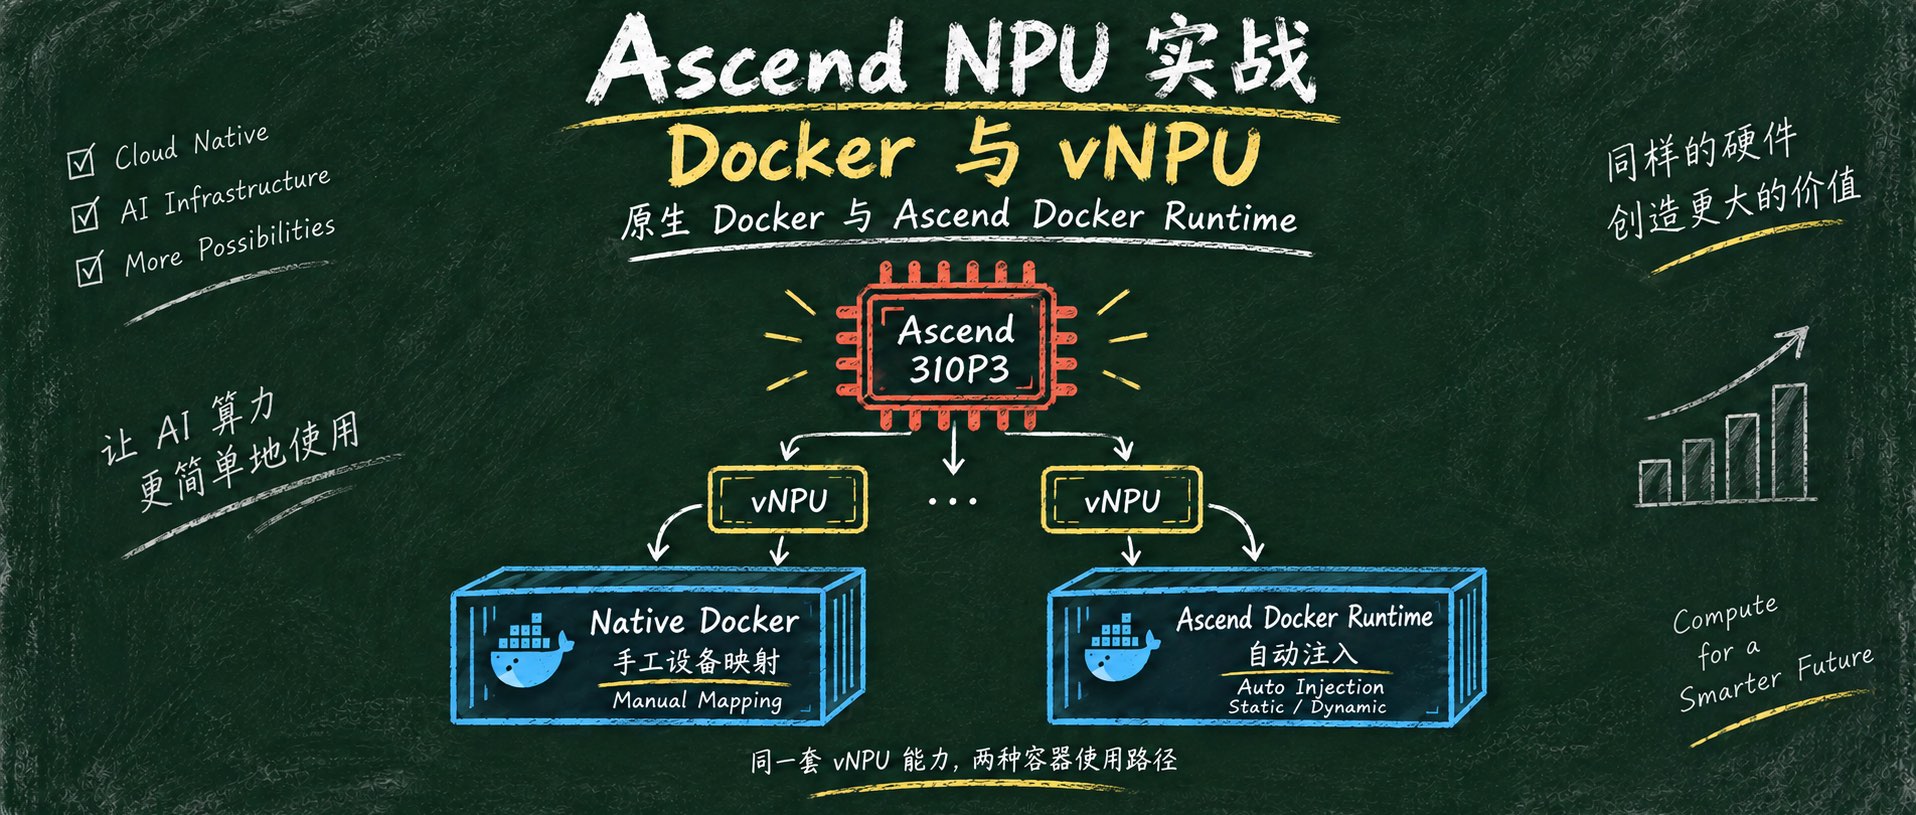
本文以 Ascend 310P3(Atlas 300I Pro)为例,介绍昇腾 NPU vNPU 的基本使用方法。 内容包括从原生 Docker 开始,演示手动创建 vNPU 并挂载到容器,以及 Ascend Docker Runtime 下的静态挂载和动态虚拟化。